所以這一頁分兩層:上半是結論(做出什麼、哪幾步成功),只想看結果的人在這裡就能停;下半是逐條的實跑紀錄,含失敗與卡住的地方。
真正有價值的是對不上的地方——那些是知道答案也擋不住的問題,下面會逐一列出。
| 來源 | 產出放在 | 包含什麼 |
|---|---|---|
| 第一次實跑 把 PART 3 的 14 條指令一口氣交出去 | part4/out/十六支程式 | 本頁下半〈逐條實跑紀錄〉的每一個數字,包括失敗的那幾步(指令 9 收到 1 顆、指令 12 的降級版) |
| 後來補做的兩件事 真正的 STEP 7、圖說的固定靶讀法 | part5/out/整合後的管線,見 PART 5 | 〈後來補做的:真正的 STEP 7〉、結論一那張全腦判定圖、以及 48 區 hub/6 區兩者皆非的分別 |
兩套產出比對過:共同的 13 份結果檔裡有 8 份內容完全相同(指令 1、4、5、6、7、8 與參數掃描、全腦估算),中間檔 .npy 也逐項相同;不同的 5 份,差異全部來自上面那兩件補做的事,沒有一處是同一段程式跑出不同答案。
所以「本頁 ≠ 拿現在的指令重跑一遍」:指令 9 那一步在這一頁仍然是照原指令(撐大 2 格)失敗的樣子,因為那正是這一頁要記錄的事;PART 5 有一張表列出最後程式改掉了哪兩個參數。而 PART 5 那條管線是可以重跑的——實測 170 秒、56 項驗收全過、產出與 part5/out/ 逐位元組相同。
結論一做出來的東西
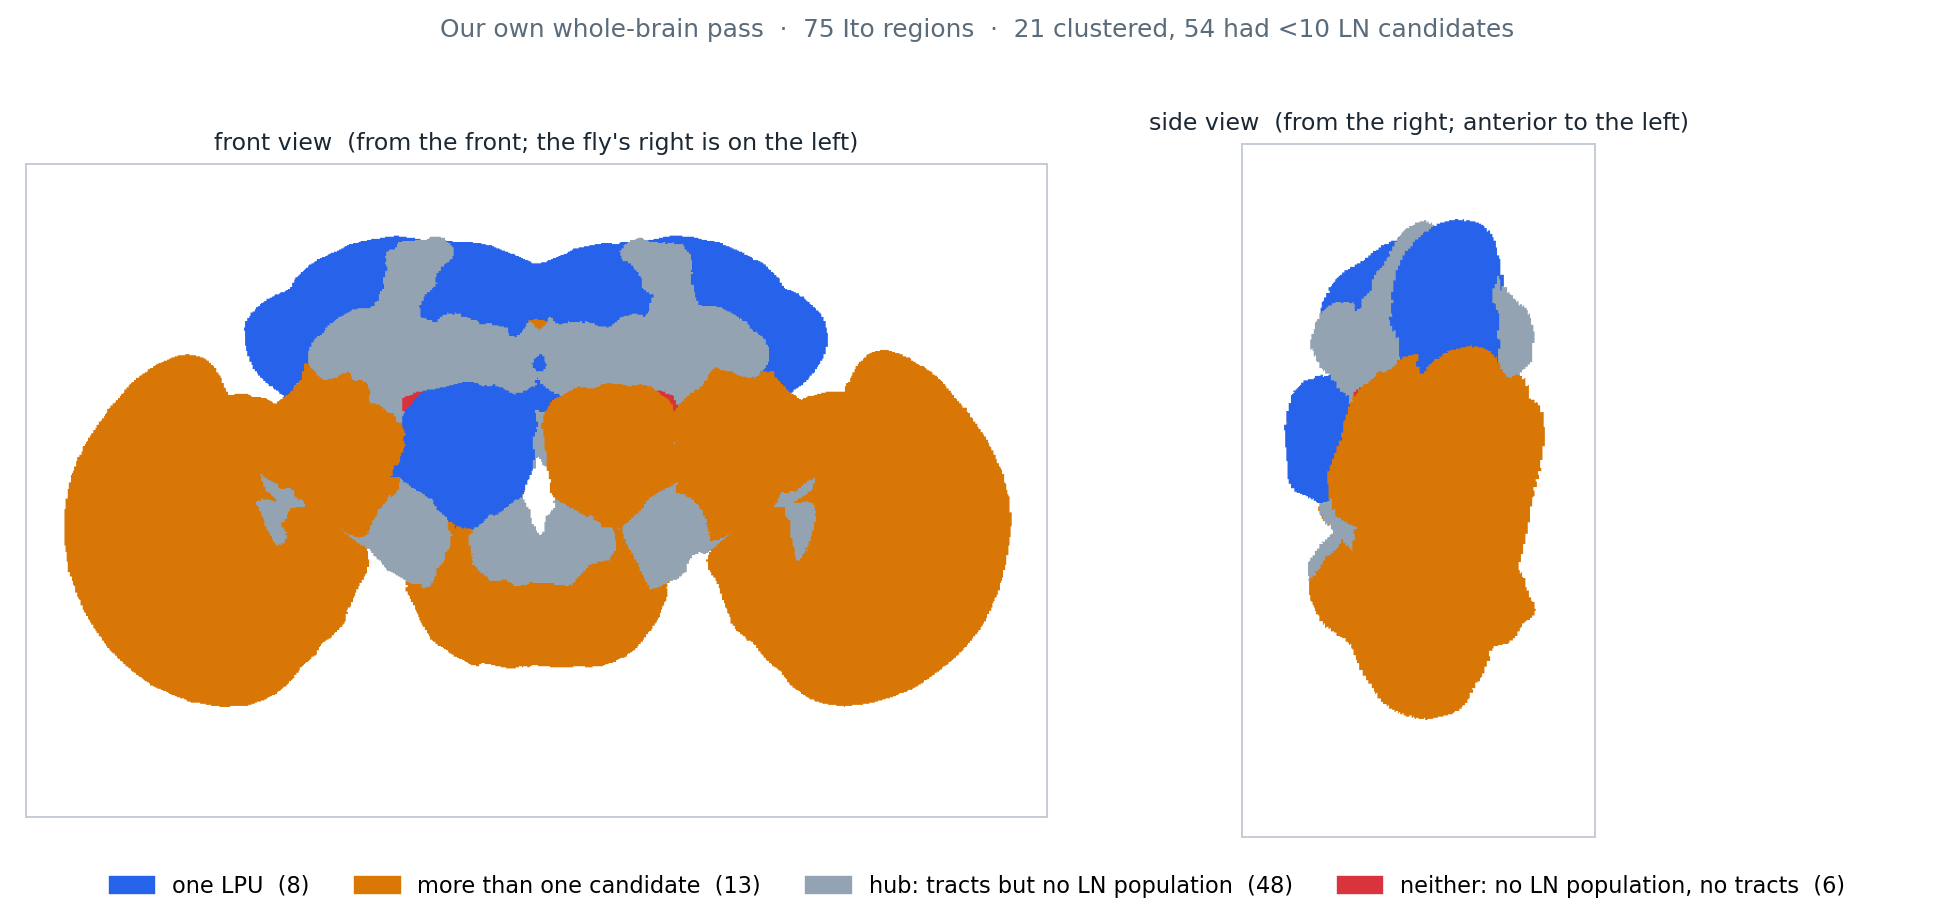
part5/run_lpu.py 算出(指令 12+14)。分區為 Ito 2014/D03,神經元為 D06 的 28,573 顆 FlyCircuit 骨架,神經束來自 FlyCircuit 的 SWC 原始檔。但它不能拿去跟論文那張 41 個 LPU 的圖並列——理由在結論三。
結論二14 條指令的成績單
| # | 指令 | 結果 | 發生什麼 |
|---|---|---|---|
| 1 | 盤點資料、確認座標框與單位 | 抓到問題(已修正) | 八項數字全對。但軸向檢查發現兩個座標框的軸序不一樣——指令 14 那張全腦圖已依此校正 |
| 2 | 定出「誰算 LN」的規則 | 全對 | 9,688/6,922/4,545/1,761 四個門檻全部吻合,曲線單調 |
| 3 | 全腦 LN 普查與敏感度掃描 | 全對 | 35/40 區、83.5% 體積、蕈狀體與結節全程 0、EB 會變——全部吻合 |
| 4 | 建單一腦區的密度場 v(r) | 抓到問題(已修正) | 兩處對不上,錯的是當時 PART 2 與 PART 3 的數字,不是這次的執行;兩頁都已改用同一個定義重算 |
| 5 | 五數綜合、取上四分位、得熱點 | 照做 | 熱點 25.0%、3,130 個體素——與 PART 2 現在的數字相同 |
| 6 | 距離矩陣、UPGMA、1% 過濾 | 照做 | 門檻 125.1 吻合。群數 5(346/455/520/798/1,011),與 PART 2 相同 |
| 7 | 切割高度掃描與打亂順序重跑 | 照做 | 高度 4 剪出 50 群但一群都沒過。六個腦區的平台值與 PART 2 完全相同 |
| 8 | 挑起始種子 | 照設計失敗 | 照字面 0 顆符合,替代規則生效——與指令設計的預期一致 |
| 9 | 膨脹與滾雪球招募 | 補充材料的讀法失敗 圖說的讀法做得出來 | 三個腦區、388 組參數全部是「只有種子」或「幾乎整池」,沒有中間值;換成圖說的固定靶讀法就跑得動,後面每一個候選族群(包括最後站得住的 AVLP_R 那 138 顆)都是這樣招募出來的 |
| 10 | 去掉本體與初級神經突、抽等值面 | 跑得動,門檻是論文的空缺 | 最鬆的門檻抽出的區域是腦區本身的 283%;門檻論文沒給,本專題取第 75 百分位(唯一小於腦區的一個) |
| 11 | 算 c 值 | 單看沒有鑑別力 加隨機對照後有(已解決) | 三個門檻算出 99.2/24.9/2.67,都通過 c > 2——隨機抽同樣顆數也照樣通過;改成跟隨機對照比,只有 AVLP_R 那 138 顆跳得出來 |
| 12 | 長程神經束驗證 | 做出來了(回頭補的) | D06 沒有存路徑,但原始 SWC 有樹狀拓樸;2,420 條神經束 |
| 13 | 合併判斷 | 全對+新發現 | 596/619/18/8,143 全部吻合。全腦掃描冒出論文沒提的合併候選 |
| 14 | 全腦跑一遍、出圖、出報告 | 21 區跑完 另 54 區卡在自訂門檻 | 計算不是瓶頸(95 秒)。54 區的 LN 少於十顆——那個 10 是自己補的門檻,換成 5 顆就有 24 區可跑;這 54 區後來靠補做的 STEP 7 分成 48 區 hub 與 6 區兩者皆非 |
結論三三個實質發現
發現一:這一步論文寫了兩次,兩次不一樣
論文的 STEP 4 寫在補充材料裡:挑一顆最小的 LN 當種子,把體素放大,重疊超過 50% 就招募進來,收進來的併成新的種子,繼續滾。照這個規則跑,在我們的資料上永遠只有兩種結果。
| 右觸角葉:招募到幾顆(池子 723 顆) | 門檻 0.30 | 0.40 | 0.50 | 0.60 | 0.70 |
|---|---|---|---|---|---|
| 撐大 2 格 | 1 | 1 | 1 | 1 | 1 |
| 撐大 3 格 | 723 | 723 | 723 | 1 | 1 |
| 撐大 4 格 | 723 | 723 | 723 | 723 | 1 |
| 撐大 5 格 | 723 | 723 | 723 | 723 | 723 |
換一個腦區,還是一樣。右觸角葉在切割高度的穩定區間上只有一群——照論文自己的規則——所有 v(r) 只形成一群時,the neuropil itself is an individual LPU——它整區就是一個 LPU,本來就沒有東西可以分。所以把同一段程式搬到兩個在整個穩定區間上都分成兩群的腦區:PB(前腦橋)與 AVLP_R。門檻由 0.30 細掃到 0.74(每次加 0.02)、撐大 1 到 5 格,四顆種子共 368 組參數:
| 腦區 | 穩定區間上的群數 | 兩群各有多少體素 | 被挑中那顆種子的侷限比例 | 招募結果出現過的值 |
|---|---|---|---|---|
| 右觸角葉(對照) | 1 群 | 3,130 | — | 整區就是一個 LPU,這一步不必跑 |
| PB(前腦橋) | 2 群 | 192/265 | 24.4%/35.5% | 1、103、104、105 |
| AVLP_R | 2 群 | 313/3,010 | 23.0%/98.7% | 1、162 |
滾雪球不是收得太多,是它根本不看你從哪一群出發。一個不看起點的程序,不可能用來把腦區分成兩塊。
AVLP_R 那顆 98.7% 的種子順帶回答了另一件事。先分清楚兩個數字:98.7% 是挑中那一顆的比例(規則是「比例最高的前十顆裡取體積最小的」,所以挑中的不是最高的那顆),最高的一顆是 99.1%——PART 2 的空缺 ④引的就是後者。論文要求種子的纖維「完全侷限在最小的候選 LPU 之內」——在這個腦區上找得到,而它照樣是開關。所以失敗的原因不是挑不到合格的種子。
原因在讀法。回頭查論文,同一個步驟被寫了兩次,寫在兩個地方,而且兩次不一樣:
圖 S5D(e) 的圖說:Visualization of two populations of candidate LNs recruited based on the coverage of the two clusters, respectively.
差別不在參數,在有沒有回饋:滾雪球每收一顆就把靶放大一次,所以它只有兩個終點——收不到任何一顆,或者一路收到底。固定靶沒有這個回饋。照第二種讀法把同樣三個腦區重跑一遍,每一群 36 組參數:
| 同樣的輸入,兩種讀法 | 補充材料:滾雪球 | 圖說:固定靶 |
|---|---|---|
| PB 的結果出現過的值 | 1、103、104、105 | 隨門檻連續變化 |
| AVLP_R 的結果出現過的值 | 1、162 | 小群 0–23、大群 37–145 |
| 兩群收到的名單 | Jaccard 1.000(同一批) | Jaccard 0.000(完全不相交) |
| 有沒有可用的操作區間 | 沒有 | 有 |
換成第二種讀法之後,三個腦區、每一群 36 組參數,沒有任何一格是開關。但通得過三道獨立檢查的,只有一個候選:
| 候選 | 換參數穩不穩 | 打亂體素順序穩不穩 | c 值高不高於隨機 | |
|---|---|---|---|---|
| AVLP_R 大群 (138 顆 LN) | 穩:撐大 0–3 格 × 門檻 0.30–0.50 共 12 組,收到 132–141 顆 | 穩:九次打亂,九次都是同一批 138 顆 | 高:4.10 對隨機的 2.84–3.00 | 通過三關 |
| AVLP_R 小群 (0–18 顆 LN) | 不穩:收幾顆完全看撐大幾格 | 穩 | 不高:1.82,落在隨機的 1.23–1.95 之內 | 退回 |
| PB 的兩群 | — | 不穩:九次打亂的名單兩兩 Jaccard 最低 0.154,九次都收到的只有 8 顆 | 不高:真實值比隨機的最小值還低 | 退回 |
c > 2,看起來每個候選都合格。但從同一個腦區的 LN 裡隨機抽同樣顆數,重複九次,也照樣通過——神經纖維本來就往中心聚,隨便抽一把都有這個性質。一個判準若沒有隨機對照,「通過」兩個字沒有內容。拿隨機對照當底線之後,五個候選只剩 AVLP_R 大群的 c 值真的跳出隨機的範圍。
所以這一步的結論是:論文對它有兩種寫法,補充材料那一種在真實資料上跑不動,圖說那一種可以;而整條流程跑到最後,站得住的候選 LPU 只有一個——AVLP_R 的那 138 顆 LN。這跟發現二是同一個主題:同一件事,論文在不同的地方寫了不一樣的話,而選哪一種會改變結果。
發現二:PART 2 的密度場,不是 PART 2 說的那個東西(已修正)
指令 4 明白寫了 v(r) 要數「有幾顆不同的神經元佔到這一格」。照這個定義算出來的 v(r),最大值是 142.8;而 PART 2 當時那張圖是 206.6。
查下去發現:當時 PART 2 的程式數的是「(體素, 神經元) 的紀錄筆數」。一顆神經元的多個 2 µm 體素併進同一個分析體素時,會被重複計入——平均每顆神經元在一個分析體素裡留下 1.44 筆紀錄。
scripts/make_part2_figures.py 的 field_of())已改成同一顆神經元在同一格只算一次,該頁六張圖與所有相關數字都重算過。PART 2、3、4、5 現在用的是同一個 v(r):右觸角葉最大 142.8、平均 65.7、熱點 3,130 個體素、高度 8 分成 5 群——四頁逐項對得起來。
換定義的影響有限,這件事量過:兩個定義的 Spearman 排序相關是 0.998(比的是平滑後的 v(r),右觸角葉區內 12,511 格),熱點集合重疊 94%。而六個腦區在切割高度 14–20 那個平台上的值,兩種定義下完全相同——不穩的中段會動,穩的結論不動。
發現三:瓶頸不是計算,是資料
指令 14 要求先估算再跑。估出來的結果跟預期相反:
| 原本擔心的 | 實際情形 |
|---|---|
| 視葉那種大區域會讓距離矩陣超出記憶體 | 沒有。最大的一區只要 0.8 GB,全腦 75 區加總 3.0 GB,跑完只花 95 秒 |
| — | 但 75 區裡有 54 區的 LN 候選少於十顆,根本沒有「族群」可以分群 |
所以最後的判定是:8 區單一 LPU、13 區多個候選,其餘 54 區的 LN 少於十顆。這 54 區後來靠 STEP 7 分成了兩類——48 區有自己的長程神經束(=論文定義的 hub),6 區連神經束也沒有(BU、CAN、GA 各一對),照定義那 6 區不能叫 hub。
但原因不是「我們的資料比較少」——我們的神經元比論文多。論文用的是約 16,000 顆已建圖神經元,其中約 26% 是 LPU 的 LN(we found ~26% of the total mapped single neurons belonging to LPU-LNs),約 4,160 顆攤在 58 個 neuropil 上,平均每區 72 顆;我們是 28,573 顆、24.2%(6,922 顆)攤在 75 區上,平均每區 92 顆。
平均密度不是問題,分布才是。我們每區的 LN 候選數中位數是 0——40 個腦區一顆都沒有,而扇形體、兩側髓質、兩側觸角葉這五個區就佔掉 4,862 顆,七成的 LN 候選集中在 5 個區裡。
兩件事指向同一個原因:Ito 的 75 區把中央腦切得比 Chiang 的 58 區細,一顆中央腦神經元的分枝散在好幾個小區裡,就通不過「80% 集中在同一區」這條規則;而論文的 LN 是人眼逐顆判讀(visually inspected and delineated),不受這條規則約束。換一份更大的神經元資料不會改善這件事,換一套分區或換一條 LN 判準才會。
結論四指令 13 冒出來的東西
指令 13 要求把「合併之後 LN 數會不會暴增」這條規則套到全腦所有相鄰的腦區配對(342 組)。論文只逐案處理了兩處,這是它沒做過的事。
| 排名 | 合併對象 | 合併後 LN | 合併前相加 | 論文有提嗎 |
|---|---|---|---|---|
| 1 | LO_R + PVLP_R | 1,252 | 349 | 沒有 |
| 2 | LO_L + PVLP_L | 1,255 | 353 | 沒有 |
| 3 | LO_L + ME_L | 1,955 | 1,341 | 沒有(論文視為不同 LPU) |
| 9 | AVLP_R + PVLP_R | 473 | 168 | 間接有 |
| 10 | AVLP_L + PVLP_L | 502 | 270 | 間接有 |
第 9、10 名是有意思的一個。AVLP 與 PVLP 在 Ito 的分區裡是兩個腦區,但它們都是 Chiang 那個「VLP」被重新劃開的產物。這條規則在完全不知道 Chiang 怎麼分的情況下,把它們挑回了同一組。
但排名第一到第八全部是視葉內部的配對(LO、ME、LOP、PVLP),而論文把髓質、小葉、小葉板視為不同的 LPU。所以這條規則在視葉上是過度合併的。它抓到了一個論文做過的合併,也提出了大量論文不會同意的合併。
結論五這張圖有多少是資料給的
指令 14 最後一項要求回答:「這個數字有多少是資料給的、有多少是我們自己選的。」
| 決定 | 值 | 誰決定的 |
|---|---|---|
| LN 判準的比例 f | 80% | 指令 2 指定 |
| v(r) 數什麼 | 相異神經元數 | 指令 4 指定 |
| 併格倍率 B | 4 | AI 依記憶體估算決定(110 GB > 16 GB) |
| 切割高度 | 掃 4–25 | 指令 7 指定不要選單一值 |
| 打亂次數 | 9 | 指令 7 指定 |
| 種子挑法 | 比例最高前十顆取最小 | AI 自己補的替代規則(在右觸角葉上,論文的條件一顆合格的都挑不到) |
| 膨脹格數 | 2 → 失敗 → 4 | 指令 9 指定 2,AI 在失敗後自己改成 4 |
| 深度去除門檻 | 10 | AI 依自己量的表決定 |
| 等值面門檻 | 三個百分位 | 指令 10 指定不要選單一值 |
| 「LN 少於十顆就不跑」 | 10 | AI 自己補的——這一條決定了 54 個腦區的命運 |
這正是這一整頁想說的事:一張圖如果沒有附上這張表,它跟論文那張沒有附參數的圖是同一個問題。
下半逐條實跑紀錄
以下是每一條指令實際跑出來的東西。只想看結論的人到這裡就可以停了。
指令 1 盤點資料、確認座標框與單位
腦區數                                75
標籤體積形狀 (z,y,x)                     (311, 611, 956)   格距 1.0
神經元數                               28573
(體素,神經元) 紀錄數                       11895201
相異體素數                              3365959
平均每體素被幾顆登記                         3.53
affine 奇異值                         [0.626, 0.605, 0.406]   det 0.154
1 格 = 幾個物理微米                       0.41–0.63
D06 體素邊長(標籤格)                      2
驗收表的八項全部吻合,包括最該盯的「1 格 ≠ 1 微米」。
但第 4 項的軸向檢查跑出一件沒預期到的事。用三組解剖關係反推,這個座標框的軸序是 axis 0 = 前後、axis 1 = 背腹、axis 2 = 左右。而 PART 1 畫圖用的那份標籤檔(FCWB 座標框)是 axis 0 = 左右、axis 2 = 前後。
FC12_warp(labels_fc_1um.npy) | FCWB(D03_FCWBNP_labels_1um.nrrd) | |
|---|---|---|
| 形狀 | (311, 611, 956) | (565, 328, 109) |
| axis 0 | 前後 | 左右 |
| axis 1 | 背腹 | 背腹(方向相反) |
| axis 2 | 左右 | 前後 |
同一份分區、兩個座標框,軸序完全不同,連共用的 axis 1 方向都是反的。PART 1 用 FCWB 畫圖、PART 2 用 FC12_warp 但沒有用到軸的意義,所以兩者都沒出錯——但這種事只要有一次搞混,圖就會左右顛倒或前後顛倒,而且不會報錯。
指令 2 定出「誰算 LN」的規則
落在某個腦區內的體素:88.0%
完全沒落進任何腦區的神經元:15 顆
f=0.8: LN 候選 6922 顆(24.2%),涵蓋 35 個腦區
f 掃描曲線單調遞減: True
   f=0.70    9688 顆   33.9%  47 個腦區
   f=0.80    6922 顆   24.2%  35 個腦區
   f=0.90    4545 顆   15.9%  25 個腦區
   f=1.00    1761 顆    6.2%  17 個腦區
四個門檻與涵蓋腦區數全部吻合,曲線單調。順帶量到一個 PART 2 沒提的數字:有 15 顆神經元的體素完全不落在任何腦區內——那是整顆都在細胞本體所在表層的極端案例。
指令 3 全腦 LN 普查與敏感度掃描
非零腦區 35 個,零 40 個
非零腦區體積佔比 83.5%,零的佔 16.5%
最多的三個:FB 1354、ME_R 1017、ME_L 988

      f      MB 合計       EB       NO  AOTU 合計     AL_R     AL_L
   0.70          2       56        0       12      794      843
   0.80          1       11        0        1      723      780
   0.90          0        0        0        0      561      654
   0.95          0        0        0        0      417      582
   1.00          0        0        0        0       43       87
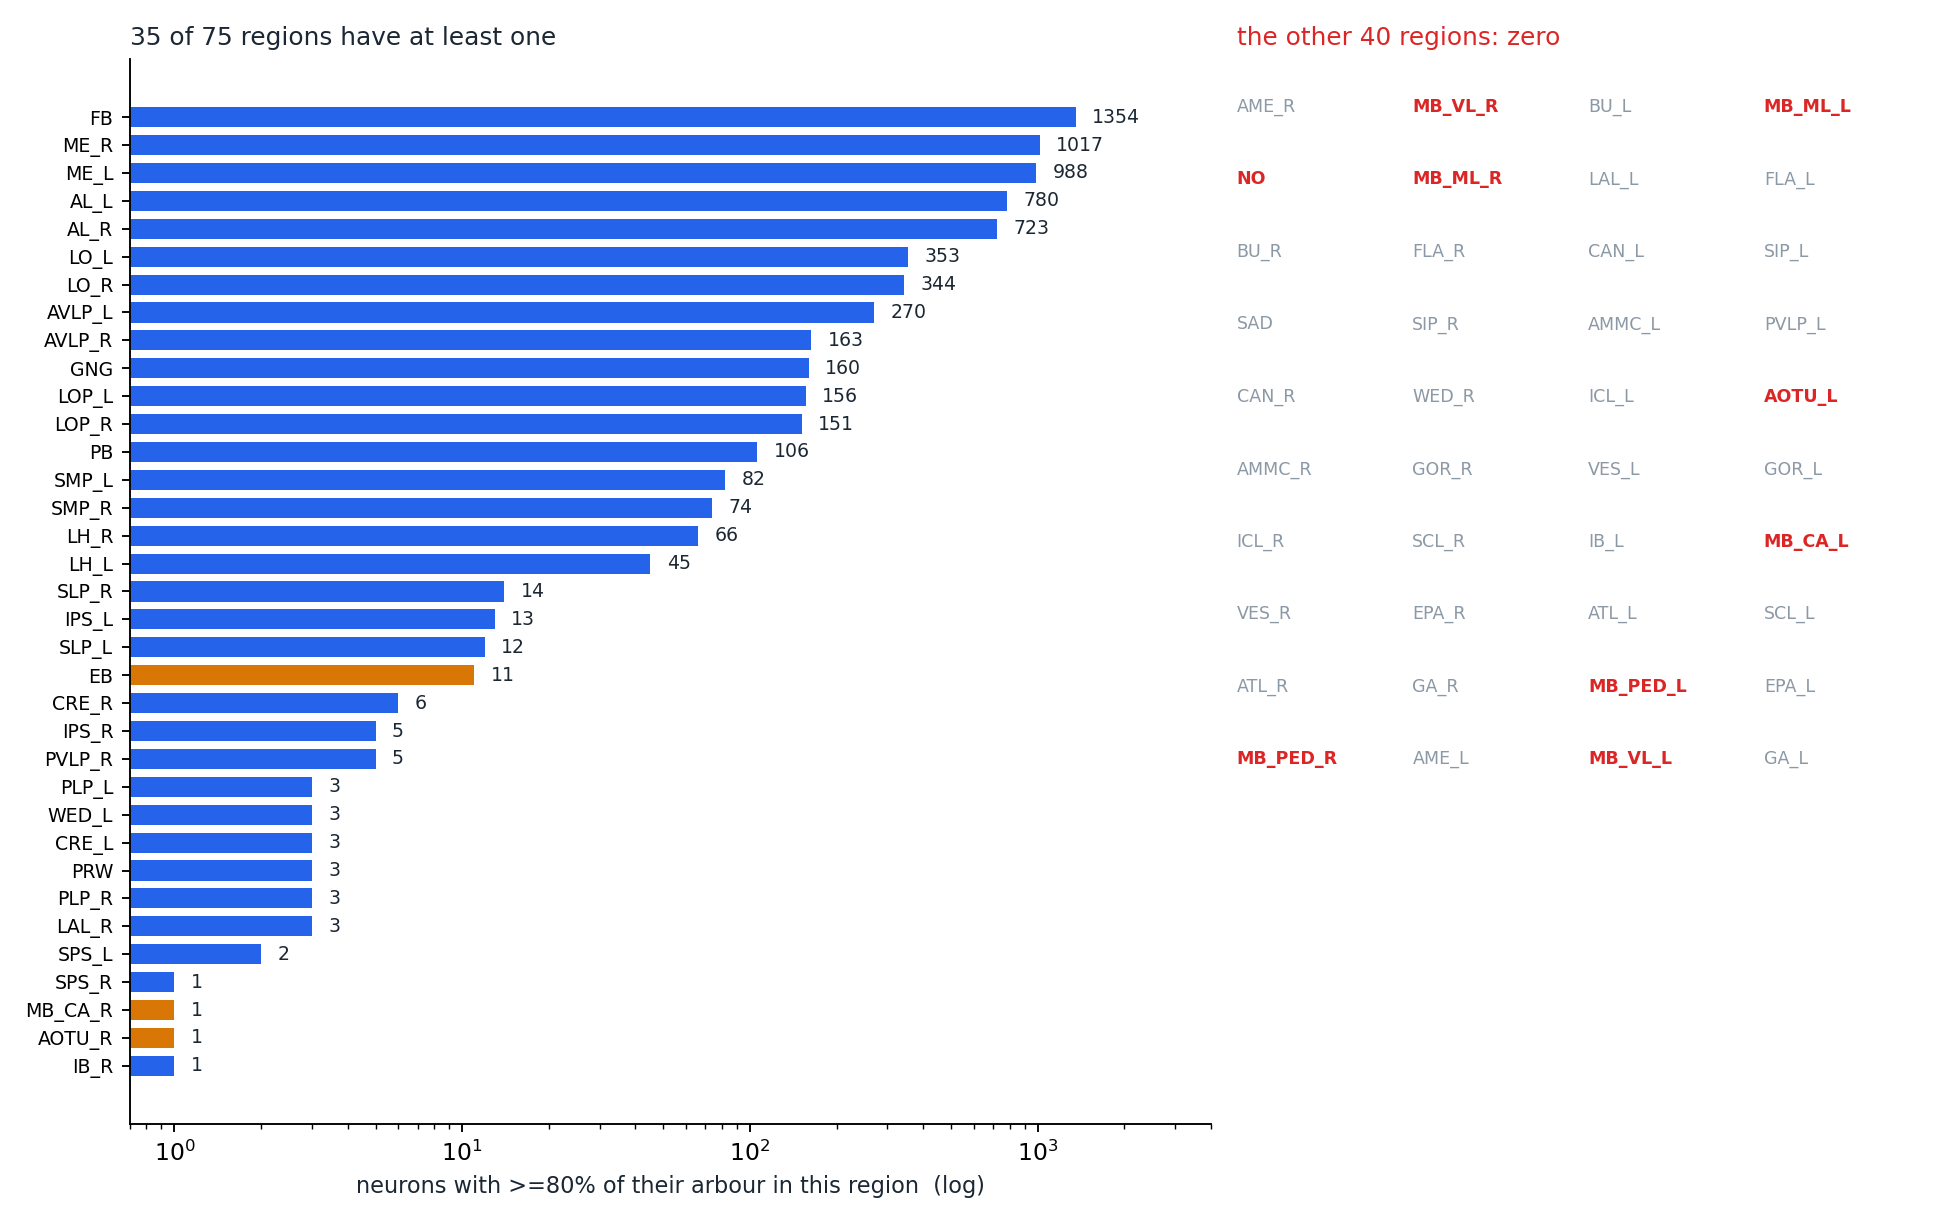
part4/scripts/c03_census.py 算出。指令 3 的陷阱題答對了:蕈狀體與結節在 f 從 70% 到 100% 之間全程接近 0,而 EB 從 56 掉到 0。只有前者是這張圖真正支持的結論。
指令 4 建密度場 v(r)
原始格點:區內 688,681 個體素,熱點約 172,170 個
  → 距離矩陣 14,821,168,365 個 float64 = 110 GB
  → 超過 16 GB,把 4x4x4 個格子併成一個分析體素
分析體素:區內 12,511 個
v(r) 最大 142.8、平均 65.7
第一處:記憶體。PART 3 當時的驗收表寫「約 20 萬個熱點、149 GB」,實際是 172,170 個、110 GB。那個數字是用「分析體素 × 64」估的,而一個分析體素通常只有一部分被填滿,所以高估了。
第二處比較嚴重:v(r) 的最大值。當時的驗收表寫 206.6,實際算出 142.8。把兩種算法並排跑:
| 算法 | 最大 | 平均 | 五數綜合 |
|---|---|---|---|
| 每一筆(體素, 神經元)紀錄都加 1 (當時 PART 2 的圖用的) | 206.6 | 94.3 | 0.6 / 51.4 / 92.9 / 136.5 / 206.6 |
| 同一顆神經元在同一格只算一次 (指令 4 指定的) | 142.8 | 65.7 | 0.6 / 36.4 / 64.9 / 94.7 / 142.8 |
比值 1.44——那是「一顆神經元平均在一個分析體素裡留下幾筆 2 µm 紀錄」。當時 PART 2 說自己用的是「重複註冊次數」,程式卻數的是紀錄筆數,是第三個東西(見發現二;那一頁現在已改用與這裡相同的定義重算)。
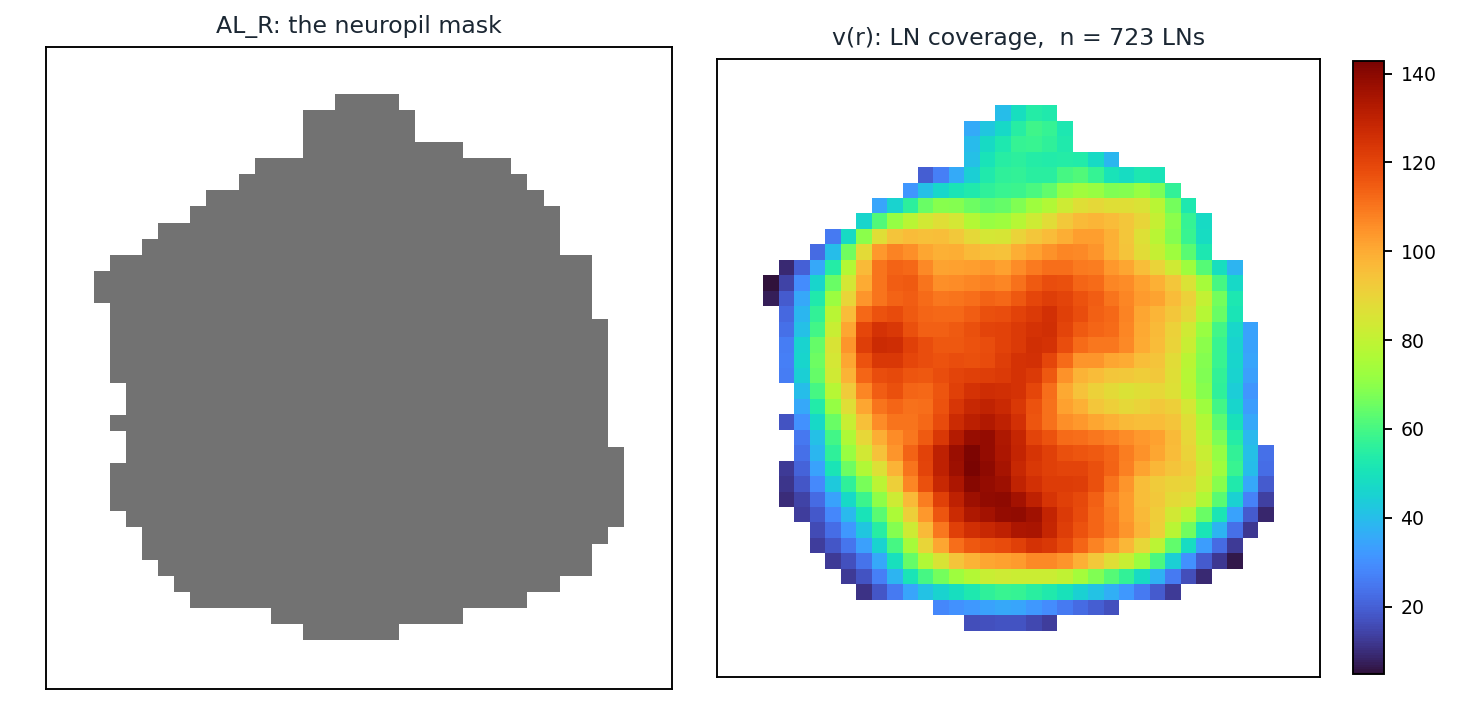
part4/scripts/c04_density.py 算出。指令 5、6 熱點與分群
五數綜合:0.6 / 36.4 / 64.9 / 94.7 / 142.8
熱點 3,130 個體素,佔區內 25.0%

規則 ② 的門檻:125.1 個體素(腦區內 12,511 個的 1%)
  注意分母是整個腦區(12,511),不是熱點(3,130)
  距離矩陣 4,896,885 個 float64 = 37 MB
高度 8:規則 ① 剪出 5 群,規則 ② 通過 5 群
各群大小:[346, 455, 520, 798, 1011]  合計 3,130
熱點比例 25.0% 與門檻 125.1 都吻合,群數是 5——與 PART 2 那張分群圖現在的結果相同(該頁已用同一個定義重算)。五群加總正好等於熱點總數,沒有漏算。
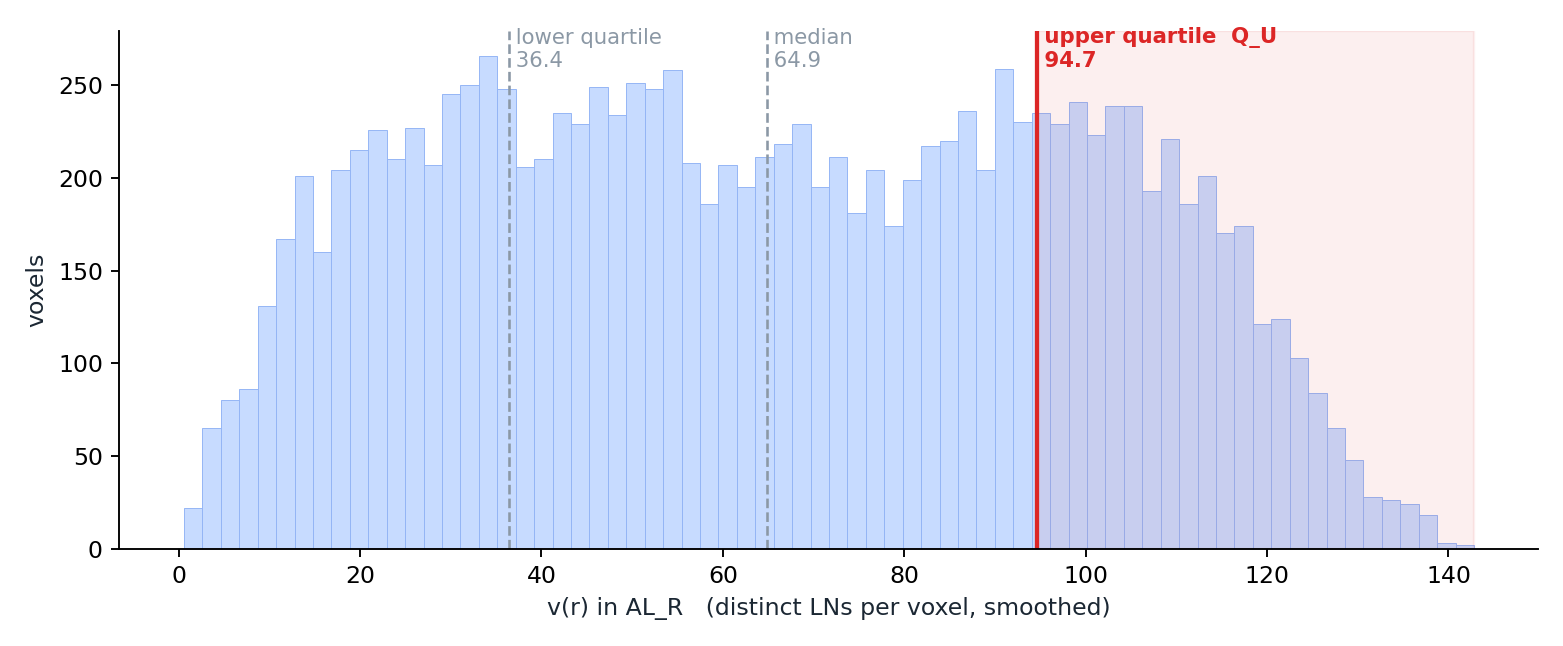
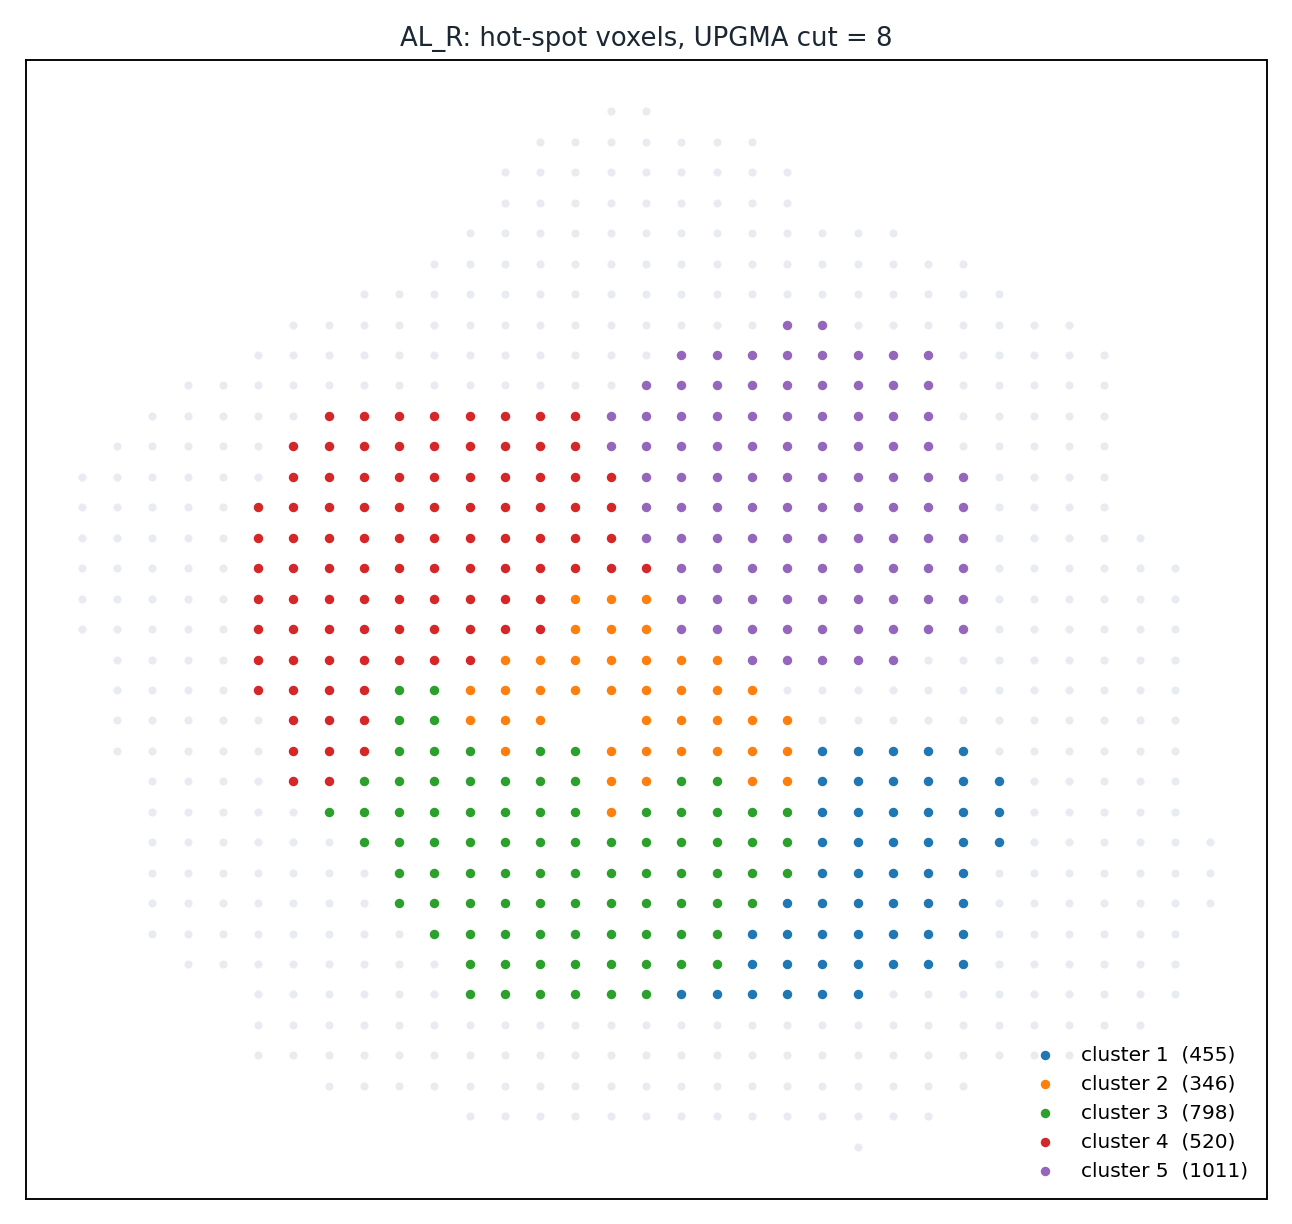
part4/scripts/c05_hotspot.py、右圖由 c06_cluster.py 算出。指令 7 切割高度掃描與打亂順序
高度 4:剪出 50 群 / 通過 0 群,最大的一群 114 個體素
高度 6 打亂九次:[13, 13, 13, 14, 14, 14, 15, 15, 15]
AL_R 距離總數 4,896,885,相異距離值 557
AL_R 樹根高度 13.1

腦區      LN   熱點   全範圍   平台14-20  同高度最大變動  樹根
AL_R       723  3130   0–15    1–1             5        13.10
AL_L       780  3130   0–14    1–2             7        13.47
AVLP_R     163  3323   0–14    2–2             8        21.24
AVLP_L     270  4012   0–16    1–2             5        19.39
FB        1354  1879   1–16    2–3             6        21.93
PB         106   457   1–11    2–2             2        20.84
高度 4「剪出 50 群、一群都沒過」完全吻合。而最值得注意的是「平台 14–20」那一欄:1/1–2/2/1–2/2–3/2——與 PART 2 完全相同。
PART 2 說「只採信打亂之後不變的結論」——現在多了一個佐證:那些結論連定義換掉都不變。
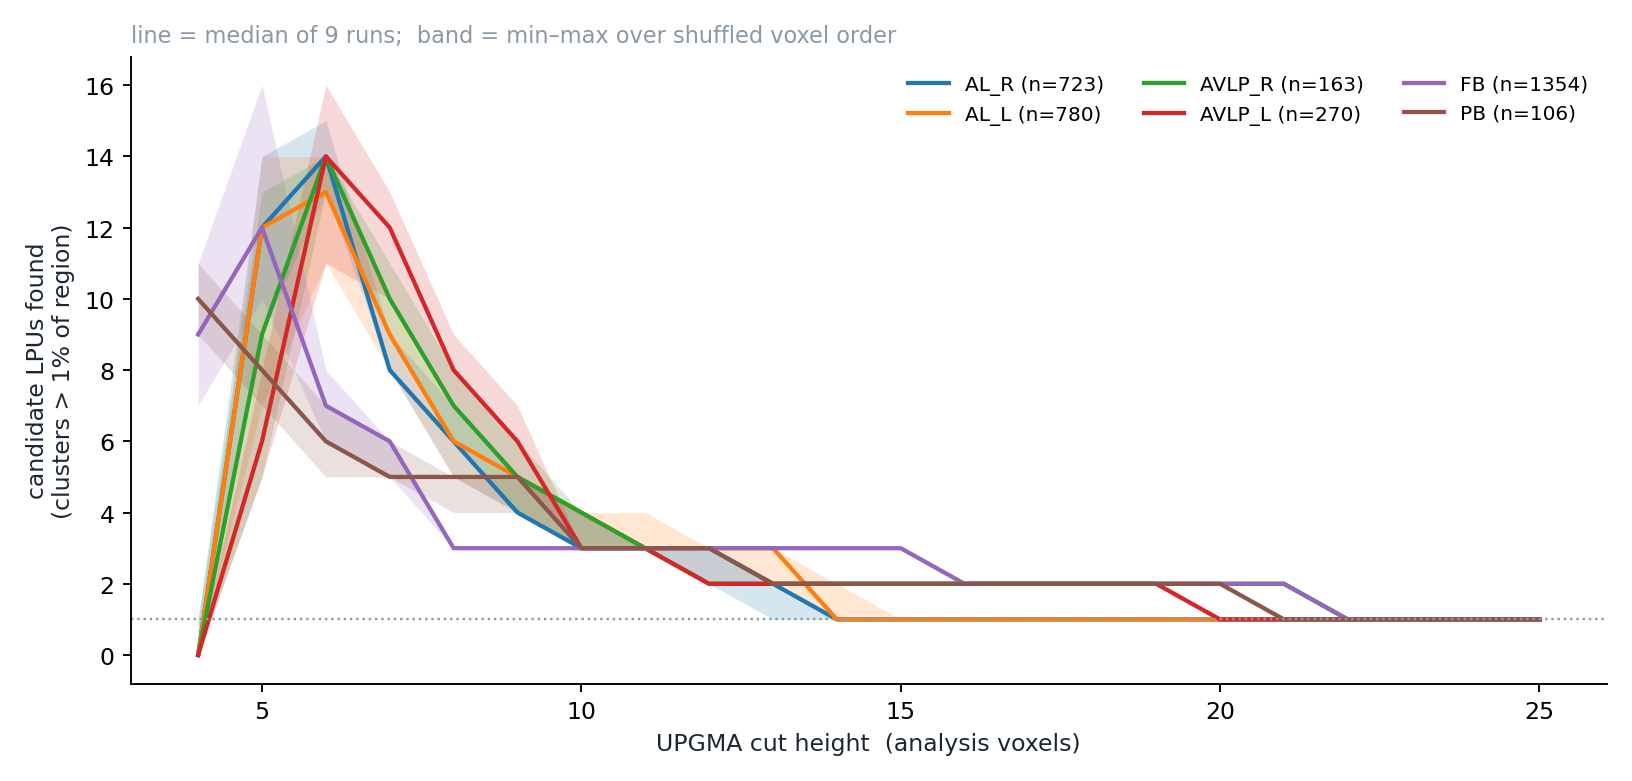
part4/scripts/c07_sweep.py 算出。指令 8 挑起始種子
最小的候選 LPU:第 2 群,346 個體素
嚴格(該群的體素集合):比例中位 4.5%、最大 23.6%、達到 100% 的 0 顆
放寬(膨脹兩格+填洞):比例中位 13.3%、最大 46.9%、達到 100% 的 0 顆

照字面挑不到 → 改用替代規則(比例最高的前十顆裡取體積最小的)
【替代規則,不是論文的條件】
選中:VGlut-F-700246  比例 22.7%  體積 128 個分析體素
「達到 100% 的 0 顆」與指令 8 的設計預期一致。順帶注意前十顆的來源:VGlut(麩胺酸)與 Gad1(GABA)佔了絕大多數——那正是觸角葉在地神經元該有的神經傳導物質,是一個沒被要求、但合理的旁證。
指令 9 膨脹與滾雪球招募
撐大幾格 → 體積變成幾倍:1 格 6.2 倍、2 格 16.9 倍、3 格 29.7 倍

敏感度檢查(撐大 source,分母用 target 原體積):
  撐大  有交集   重疊率中位  最大   >50%
     0    96.4%       0.015   0.10    0.00%
     1    99.6%       0.092   0.35    0.00%
     2   100.0%       0.238   0.68    5.88%
     3   100.0%       0.398   0.90   35.20%

開始招募,種子=VGlut-F-700246,撐大 2 格,門檻 50%
招募結束:1 顆(佔 0%),共 0 輪
敏感度表四列全部與 PART 3 的驗收表吻合——所以實作沒有寫錯。但用同一個設定跑招募,一顆都收不到。
診斷下去:種子是 723 顆裡第 12 小的(146 個 2 µm 體素,全體中位是 1,630——比中位小 11 倍)。撐大 2 格後對 120 顆的最大重疊率只有 0.251。
| 撐大 | 種子體積變成 | 對 120 顆的最大重疊率 | 超過 50% 的 |
|---|---|---|---|
| 2 格 | ×20.0 | 0.251 | 0 顆 |
| 3 格 | ×40.1 | 0.410 | 0 顆 |
| 4 格 | ×64.3 | 0.540 | 5 顆 |
| 若改從最大的一顆起頭、撐大 2 格:最大重疊率 0.678,96 / 120 顆過門檻 | |||
問題出在論文自己的規則:它要求從「最小的 LN」開始。一個小的 source,撐大之後仍然裝不下一顆較大 target 的一半體積。「從最小的開始」與「重疊超過 target 的 50%」這兩條,在右觸角葉上互相矛盾。
改成撐大 4 格之後雪球啟動了——然後三輪之內吞下全部 723 顆(17 → 177 → 528)。這才做了那張 20 格的掃描表,結果是沒有任何一格落在中間。
這一格後來又被追了三輪:換腦區、換讀法、換驗證方式。結果寫在上面〈發現一〉那一節。
part5/lpu_lib.py 兩種都實作了(recruit() 與 recruit_coverage()),而管線跑到滾雪球那一種時會停下來,不硬產出看起來完整、其實沒有意義的結果。指令 10、11 等值面與 c 值
深度分段(招募到的 723 顆,1,297,426 個體素)
   深度       體素數    落在該區外   落在任何腦區外
     0–5        4,271        63.2%           61.7%
    35–65     614,497         8.0%            5.3%
   → 用「深度 < 10 丟掉」,丟掉 9,918 個體素(0.8%)

等值面三個門檻
   門檻(百分位)   值    區域體素   佔腦區
    25           0.1    35,407    283.0%
    50           0.9    23,426    187.2%
    75          22.3    11,689     93.4%

c 值(判準 c > 2)
   門檻   ΣA/N_A   ΣB/N_B     c     通過?
    25       31.7      0.3  99.243   是
    50       47.3      1.9  24.907   是
    75       80.0     30.0   2.665   是
深度分段的兩個關鍵值(61.7%、5.3%)與驗收表吻合。
但等值面出了問題:最鬆的門檻抽出來的區域是腦區本身的 283%——因為招募到的神經元有一部分伸到 AL_R 之外,密度場跟著溢出。只有第 75 百分位那個門檻給出小於腦區的結果。
一、c 值沒有鑑別力:解決了。問題不在 c 算錯,而在沒有虛無模型。後來從同一個腦區的 LN 池子隨機抽同樣顆數、重複九次當對照,這個判準就分得出東西了:只有 AVLP_R 那 138 顆跳出隨機分布(4.10 對隨機的 2.84–3.00),另外四個候選的真實 c 值都落在隨機範圍之內、甚至更低,因此被退回。見上面〈發現一〉那張表。
二、等值面的門檻:沒有解,因為論文根本沒給。isointensity surface 在全文只有名字、沒有數值。同一批神經元只換這個門檻,抽出來的區域從腦區的 373.7%(第 10 百分位)縮到 37.4%(第 90 百分位),c 值從 248.9 掉到 1.22——205 倍,中途跨過 c > 2。本專題一律取第 75 百分位,那是唯一讓區域小於腦區的一個;它是我們挑的,不是論文給的,所以列在 PART 2 的〈十個要自己決定的地方〉第 ⑥ 項(那裡有完整的掃描表)。
指令 12 長程神經束驗證
完整的綁束演算法需要每顆神經元在兩區的終點平均位置與最短路徑,
D06 沒有存路徑,只有體素與離本體的深度 → 無法照補充材料實作。
降級為:『有幾顆神經元同時碰到 AL_R 和另一個腦區』(每區至少 5 個體素)。
與原版的差別:沒有做軌跡分群,所以算出來的是「連結對象」不是「神經束」。

碰到 AL_R 的神經元 1,910 顆,其中同時碰到別區的:
   AL_R ↔ LAL_R        941 顆
   AL_R ↔ VES_R        750 顆
   AL_R ↔ LH_R         648 顆
   AL_R ↔ CRE_R        489 顆
   AL_R ↔ MB_CA_R      449 顆
指令 12 的驗收項有一條說「AL_R 連出去的對象應該包含蕈狀體萼與側角」——兩個都在名單上(MB_CA_R 449 顆、LH_R 648 顆)。那正是嗅覺投射神經元的兩個標準去處。
但排在最前面的是 LAL_R 與 VES_R,那不是文獻上的主要嗅覺路徑。降級版沒有做軌跡分群,所以它抓到的是「路過同一區」而不是「走同一條路」——這正是原版演算法要濾掉的東西。
後來補做的:真正的 STEP 7
降級的理由是「D06 沒有存路徑」。這句話對,但不完整:D06 是把 SWC 骨架柵格化成體素之後的產物,原始的 SWC 檔有 idpar 欄位——每個節點的親代是誰,也就是完整的樹狀拓樸。D06 的載入器讀了它、算完到細胞本體的距離就丟掉了。拿回來就做得到。
FC12_warp 影像檔標頭寫著 BoundingBox 與格數——相除得到三軸都正好 1.0000 µm(抽查五個檔案都一樣)。所以門檻是 30 µm。
全量 28,573 顆 SWC,102 秒
   找出終端落在兩個腦區的:17,690 顆
   路徑總長:中位 140 µm、最長 1,339 µm

綁束(30 µm、長度相似度 0.6):2,420 條神經束(每條至少 3 顆)
   被神經束連起來的腦區配對:283 組
   75 區裡 69 區有自己的神經束,6 區沒有:BU_R、CAN_R、GA_R、BU_L、CAN_L、GA_L
綁束這一步又碰到跟 指令 9 一樣的問題:論文說相似的路徑「were bundled into a single tract」,但沒說相容關係不遞移時怎麼辦。在 30 µm 這個門檻下,三種綁法差得很遠:純連通分量最大的一束是 2,057 條路徑(11.6%),限定同一組腦區之後降到 695 條,改成「同一組腦區+一束之內兩兩都要相似」之後最大的一束只剩 85 條。而且純連通分量離滲流只差幾微米——門檻放寬到 35 µm,最大一束就吞掉 9,761 條(55%),40 µm 是 12,891 條(73%)。這是我們的選擇,不是論文的規定。
拿神經束去驗候選 LPU
論文的驗證條件是「a sub-division with c>2 is an LPU if the region has its own long-range tracts」——關鍵在「自己的」。拿 AVLP_R 那兩個候選來試(發現一裡通過三關的那個大群,以及被退回的小群):
| AVLP_R 的候選 | 招募到的 LN | 端點落在它邊界內的神經束 |
|---|---|---|
| 小群(313 熱點體素) | 11 顆 | 30 條 |
| 大群(3,010 熱點體素) | 138 顆 | 20 條 |
| 兩者共用:0 條 | ||
但兩塊空間上分開的邊界,本來就會收到不同的神經束——「0 條共用」有可能是幾何上的必然,不是證據。所以照發現二那一節的作法加隨機對照:從同一個 LN 池子隨機抽 11 顆與 138 顆、走完全一樣的流程建邊界。
| 兩塊共用的神經束 | |
|---|---|
| 隨機抽九次 | 28、32、8、10、39、52、9、21、13(中位 21,最少 8) |
| 真實的兩個候選 | 0 |
所以 AVLP_R 那 138 顆 LN 的候選,c 值高於隨機、也有自己的長程神經束——論文的兩個驗證條件都過了。小群則是神經束通過、但 c 值只有 1.82,連 c > 2 都沒到;兩個條件是「且」,所以它不成立。
指令 13 合併判斷
一、二、指定的三組
   MB_R   合併前 MB_CA_R 1、MB_PED_R 0、MB_VL_R 0、MB_ML_R 0  → 合併後 596
   MB_L   合併前 四塊全是 0                                  → 合併後 619
   EBLT   合併前 EB 11、BU_R 0、BU_L 0                       → 合併後 18
   全腦 LN 候選 6922 → 8143(多了 1221)

三、空間相鄰的腦區配對:342 組
   Δ全腦   合併對象                 合併後  合併前(相加)
     903   LO_R      + PVLP_R        1252         349
     902   LO_L      + PVLP_L        1255         353
     614   LO_L      + ME_L          1955        1341
     ...
     305   AVLP_R    + PVLP_R         473         168
     232   AVLP_L    + PVLP_L         502         270
指定的三組全部吻合驗收表。第三項的全腦掃描是論文沒做過的事,結果見上面的結論四。
指令 14 全腦跑一遍
指令 14 第二項要求「估算完停下來等確認」。估算結果推翻了原本的擔憂:
分類:可以跑 21 區、體素太多 0 區、LN 太少 54 區
全部 75 區的距離矩陣加總約 3.0 GB(不是同時,是逐區)
最大的一區單獨就要 0.8 GB

【依指令 14 第二項,估算完成,停在這裡等確認】
建議的處理方式:
  · LN 少於 10 顆的區:不跑分群,直接判定「沒有自己的 LN 族群」→ 候選 hub
那個「10 顆」是 AI 自己補的門檻,而它決定了 54 個腦區的命運——見結論五那張表的最後一列。
確認之後跑完 21 區,總共 95 秒:
| 腦區 | LN | 熱點 | 全範圍 | 平台 14–20 | 樹根 | 判定 |
|---|---|---|---|---|---|---|
| FB | 1,354 | 1,879 | 1–13 | 2–3 | 21.9 | 候選 2–3 個 |
| ME_R | 1,017 | 15,166 | 0–14 | 4–11 | 32.9 | 候選 4–11 個 |
| ME_L | 988 | 15,203 | 0–14 | 5–10 | 33.1 | 候選 5–10 個 |
| AL_L | 780 | 3,130 | 0–14 | 1–2 | 13.5 | 候選 1–2 個 |
| AL_R | 723 | 3,130 | 0–14 | 1–1 | 13.1 | 單一 LPU |
| GNG | 160 | 11,083 | 0–15 | 3–7 | 34.5 | 候選 3–7 個 |
| PB | 106 | 457 | 1–12 | 2–2 | 20.8 | 候選 2 個 |
| SMP_L / SMP_R | 82 / 74 | 2,882 / 2,875 | 0–16 | 1–1 | 13.1 / 13.5 | 單一 LPU |
| LH_R / LH_L | 66 / 45 | 1,626 / 1,475 | 1–15 | 1–1 | 9.6 / 8.9 | 單一 LPU |
| EB | 11 | 659 | 1–14 | 1–1 | 10.9 | 單一 LPU |
| 另有 SLP_R、SLP_L、IPS_L、LO_R、LO_L、LOP_R、LOP_L、AVLP_R、AVLP_L 共 9 區,以及 54 區因 LN 不足未跑 | ||||||
兩側髓質(ME)在平台上給出 4–11 個候選,是全腦最不穩的。那是視葉裡神經元最多的區域,也是我們的 LN 候選最多的地方之一——LN 多不代表分得清楚。
而橢球體(EB)只有 11 顆 LN 候選,卻穩定判成單一 LPU。那跟論文正文的說法一致,但跟論文圖 5A 給它的「−」不一致——PART 1 的坑三在我們的資料上仍然沒有解決。
一、沒跑完的 54 區:不是資料不足,是我們自己設的門檻。那 54 區的 LN 候選少於 10 顆,而這個 10 是 AI 自己補的,論文只說 LN 要成「族群」(population),沒有給數字。門檻換一個,能跑的區數就跟著換——PART 2 已經把整條曲線量出來了:至少 1 顆有 35 區、至少 3 顆 30 區、至少 5 顆 24 區、至少 10 顆 21 區、至少 20 顆 17 區。所以「54 區沒跑」是一個可以調的決定,不是做不到。
二、那 54 區後來分得出兩種了:已解決。當時 STEP 7 是降級版(用「碰到同一個腦區」代替神經束),所以沒有 LN 族群的區只能一律叫 hub。回頭把真正的 STEP 7 補上之後,54 區分成 48 區 hub(有自己的長程神經束、但沒有 LN 族群)與 6 區兩者皆非(連神經束都沒有:BU、CAN、GA 的左右各一)——論文對 hub 的定義本來就要求有神經束。那張全腦判定圖的方位也已依指令 1 量到的軸序校正過。
三、判定跟論文對不上:這不是沒跑完,是結論。我們得到 8 個單一 LPU,論文是 41 個 LPU。三個原因都不是計算量:分區不同(Ito 的 75 區對 Chiang 的 58 區,其中 14 個舊名字在新系統裡找不到對應)、LN 判準不同(我們用「至少 80% 的分枝待在同一區」,論文是目視判定)、以及那十個論文沒交代的決定。計算從頭到尾不是瓶頸:全腦 95 秒、距離矩陣加總 3.0 GB。
收尾把這一遍的意義講清楚
但那不是這一遍的產出。產出是這一頁的其他部分——十四條指令裡,哪幾條照做就有結果、哪幾條會抓到上游的錯、哪一條在任何參數下都跑不出有意義的東西。
三件事值得單獨記下來:
一、AI Agent 最大的價值不是寫程式,是逼你把話講死。PART 3 那 14 條指令裡真正花掉篇幅的,全是「論文含糊、你必須指定」的地方。而這一遍證明了那些指定是必要的——指令 9 沒有指定「撐大誰」時,四種讀法會給出差三倍的結果;指令 8 沒有先叫它照字面試一次時,替代規則會被當成論文的作法。
二、驗收表比指令本身更有用。指令 4 的驗收表對不上,才追出當時 PART 2 的密度場定義寫錯了(兩頁都已更正)。如果只給指令、不給預期數字,那個錯會一路傳下去,而且每一步看起來都很正常。
三、失敗的那一條是最有資訊量的。指令 9 跑不出中間結果,追下去才發現那不是實作的問題,是論文對這一步寫了兩種不一樣的話,而我們照著跑的那一種在真實資料上不成立。一條跑成功的指令只告訴你「做得到」;一條失敗的指令會逼你回去重讀論文,那通常更值錢。
part4/scripts/,共十六支、740 行。