先看全貌整條流程長這樣
七個步驟,加上兩件不在步驟裡的事。左邊黃色虛線框的「合併」是論文實際做了、但沒有寫成判準的操作——照著七個步驟跑,永遠跑不出蕈狀體與中央複合體那兩個 LPU。上方的 STEP 0 也一樣:它是七個步驟的前提,論文沒有把它算成一步。
本圖依 Chiang et al. (2011) 正文的七步驟條列與補充材料〈Defining an LPU〉自行繪製,非原圖重製。- 體素=把腦切成一格一格的小立方體,一格就是一個體素(voxel)。本頁的圖與數字都是在這種格子上算的(STEP 1 開頭會再講一次)。
- Z=熱點集合,也就是第 2 格留下來的那 25% 體素(STEP 2)。
- UPGMA=一種階層分群法,全名 unweighted pair group method with arithmetic mean,中譯「不加權平均連結法」。它反覆把「彼此平均距離最近」的兩群併起來,長出一棵樹,你再決定在哪個高度把樹剪斷(STEP 3;「平均」是在講兩群之間的距離怎麼定,見〈什麼是「連結法」〉)。
論文自己跑過一次,全篇只有這一個實例
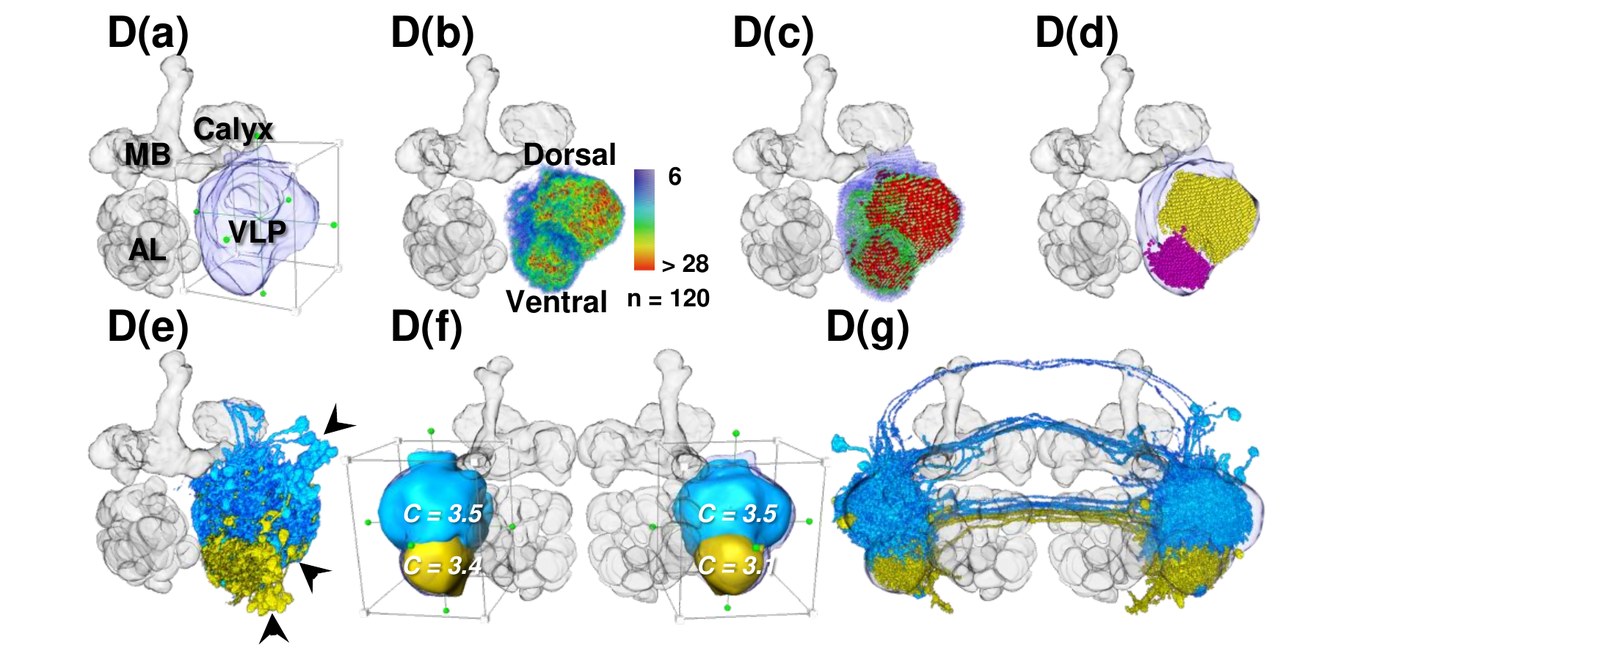
那七個步驟,論文只示範過一次——把左側腹外側前腦(VLP)切成背側與腹側兩塊。整個示範就是下面這七格,本頁後面每一節都在拆解它:
STEP 0你得先有兩樣東西
七個步驟的輸入不是原始的顯微鏡影像。它預設你手上已經有:
- 一套 neuropil 分區。論文用的是 58 個(每半腦 29 個)。這套劃分不是論文自己發明的——補充圖 S2(B) 寫的是「For each brain hemisphere, 29 demarcated neuropil regions as defined previously [1] were segmented」,而 [1] 是 FlyBrain 圖譜(Armstrong et al., 1995, Neuron 15:17–20),也就是 2014 年新命名法出現之前大家共用的那一套。論文做的是把既有的分區切到自己的標準腦上(原句:segmented into 58 morphologically distinguishable neuropil regions)。
- 一份「哪些神經元是 LN」的標記。
第二項有個先後問題。論文對 LN 的定義是「神經突完全侷限在單一個腦區之內」——哪個腦區?答案是既有的 neuropil。所以整條路是:
在我們自己的資料上做一次
這一步不必只停在紙上。本機有兩樣現成的東西:D03 的標準腦分區(Ito 2014 的 75 個腦區)與 D06 的 28,573 顆 FlyCircuit 骨架體素。缺的只有一樣——怎麼判定一顆神經元是不是 LN。
但論文是目視判讀每一顆神經元的支配範圍(visually inspected and delineated),我們沒有那雙眼睛,得把這句話翻成一條算得出來的規則。
我們用的規則是比例:
結果
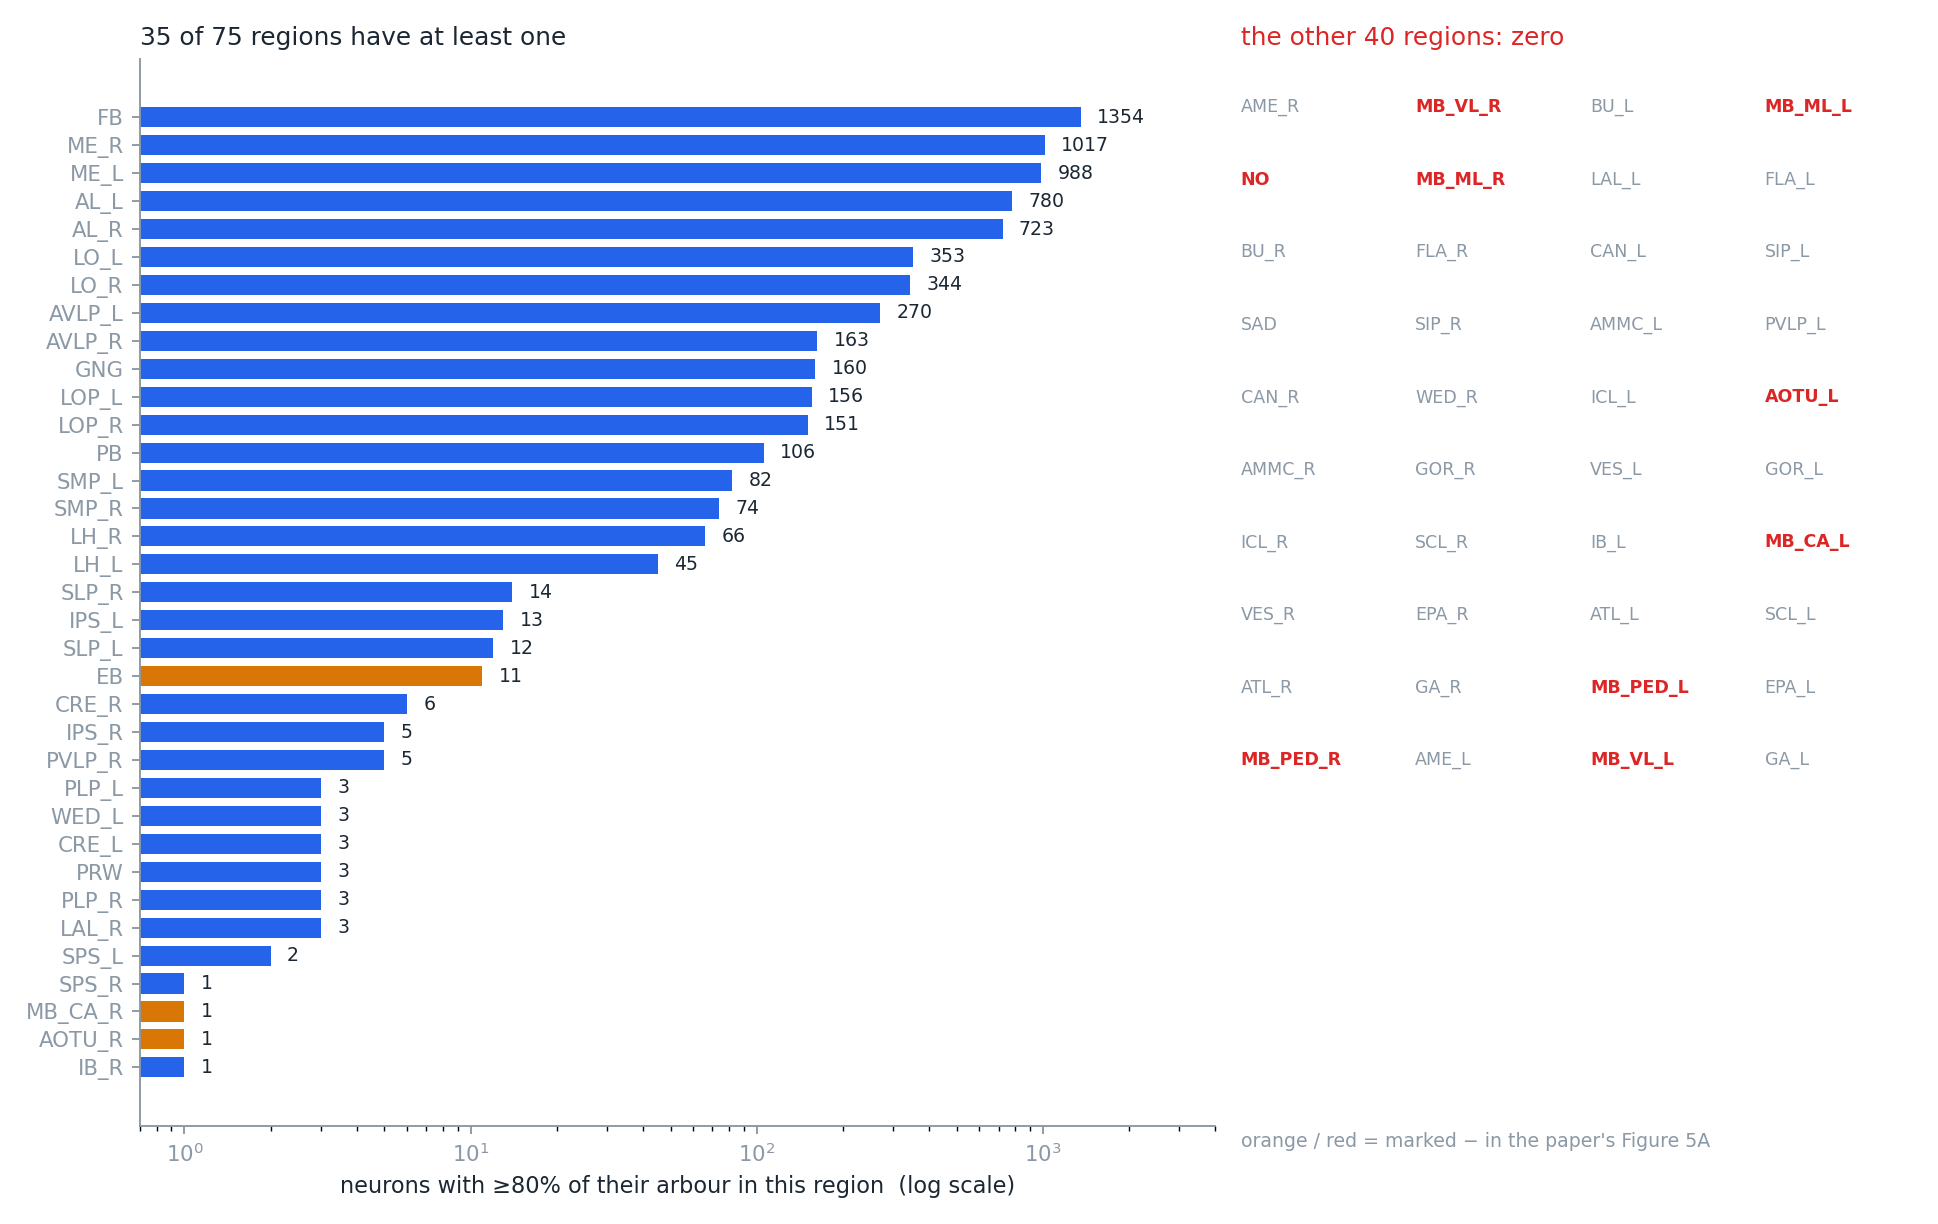
28,573 顆裡有 6,922 顆符合,佔 24.2%。論文報的是「約 26% 的神經元屬於 LPU-LN」。這 6,922 顆分布在 75 個腦區中的 35 個:
scripts/make_part2_figures.py 算出。資料:D06 的 28,573 顆骨架體素 + D03 的腦區標籤。「族群」至少要幾顆
先看那 35 個腦區的內部結構:其中 12 對是左右都有的(AL、AVLP、CRE、IPS、LH、LO、LOP、ME、PLP、SLP、SMP、SPS),其餘 11 個是單側或本來就不成對。但清單尾端有一串只有 1 到 3 顆的腦區——那稱不上「族群」。論文的用字是 population(族群)——一個族群不會只有一兩顆。
| 要求「族群」至少幾顆 | 符合的腦區數 | 其中左右都有的對數 |
|---|---|---|
| ≥ 1 | 35 | 12 |
| ≥ 3 | 30 | 11 |
| ≥ 5 | 24 | 9 |
| ≥ 10 ← PART 4 全腦那一遍用這個 | 21 | 8 |
| ≥ 20 | 17 | 7 |
這個門檻是我們自己設的,論文沒有給數字——它只說 LN 要成 population(族群)。把「族群」定成至少 10 顆,剩下 21 個腦區;定成 5 顆就有 24 個。PART 4 的全腦那一遍用的正是「至少 10 顆」,所以有 54 個腦區沒有進入分群——那是這個門檻擋掉的,不是資料不夠。
把 80% 換成別的數,結論會不會翻
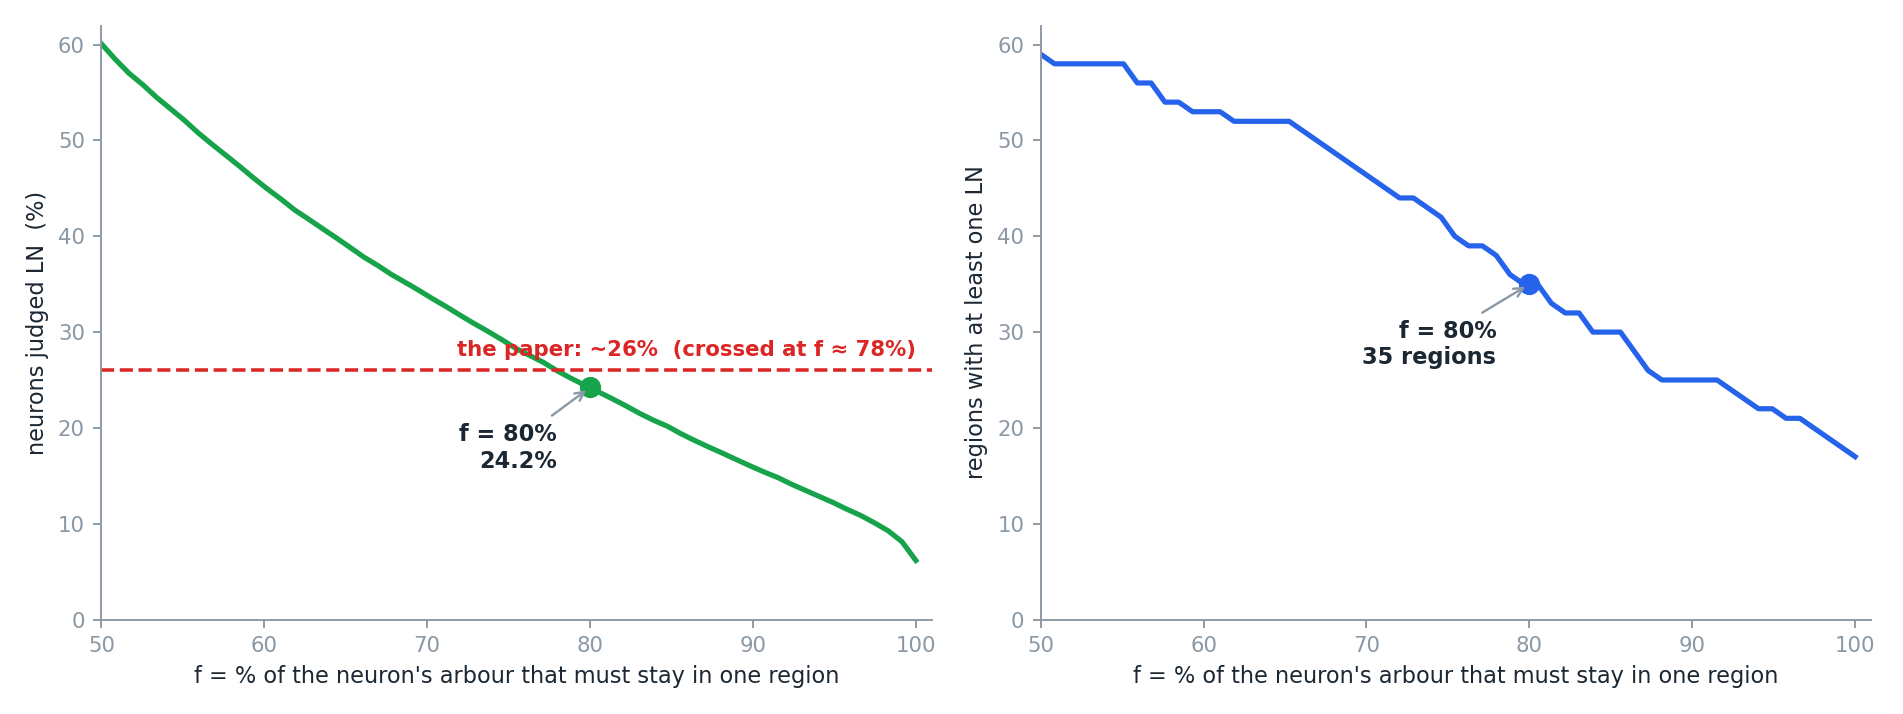
會動,但不是每一項都動。把 f 從 50% 一路掃到 100%(下面那張圖的兩端就是這兩個值;再下面那張表只挑其中五個值列出來):
scripts/make_part2_figures.py 算出。| f | LN 候選 | 非零腦區 | 蕈狀體四塊合計 | EB | 結節 NO | AOTU 兩側 |
|---|---|---|---|---|---|---|
| 70% | 9,688(33.9%) | 47 | 2 | 56 | 0 | 12 |
| 80% ← 本專題採用 | 6,922(24.2%) | 35 | 1 | 11 | 0 | 1 |
| 90% | 4,545(15.9%) | 25 | 0 | 0 | 0 | 0 |
| 95% | 3,469(12.1%) | 22 | 0 | 0 | 0 | 0 |
| 100% | 1,761(6.2%) | 17 | 0 | 0 | 0 | 0 |
不穩的部分:EB。從 56 掉到 11 再掉到 0,是唯一一個隨 f 改變判定結果的。而 EB 正是論文自己前後不一致的那一個(正文把它列為三個中央不成對 LPU 之一,圖 5A 卻給它「−」)。
AOTU 不能算進來。它在 f = 70% 時有 12 顆、80% 以上掉到 0–1,看起來像圖 5A 的 OPTU;但如 PART 1 所述,Ito 的正文從未列出 OPTU → AOTU 這條對照,我們不能拿一個沒確認過的對應去佐證。
順帶回答:75 區真的比 58 區細嗎
就名字的數量而言是的,但兩者不是「同一張圖再切幾刀」的關係。
| Chiang 2011 沿用 FlyBrain 1995 | Ito 2014/D03 | |
|---|---|---|
| 標籤總數 | 58 | 75 |
| 組成 | 29 個名字 × 左右兩份 | 34 個名字 × 左右兩份 + 7 個中線 |
| 不同的名字 | 29 | 41 |
但如 PART 1 第 3 節所列,Chiang 那 29 個名字裡有 14 個在新系統裡找不到對應——因為 Ito 是在一大片本來就沒有明確邊界的「瀰漫性」腦區上重新劃線,不是把舊的區再切開。所以「細」是就平均而言,不是每一處都是舊區的子集。所以就算把 Ito 明顯切開的幾組併回去,也只能說是「往 58 的方向靠」,不是還原 Chiang 的分區。
STEP 1數 LN 纖維,得到密度場 v(r)
r(i, j, k) 就是第 i 行、第 j 列、第 k 層的那一格。本頁在白話的地方也會直接叫它「格子」或「一格」,指的是同一個東西。
令 r(i, j, k) 為腦中的一個體素。每個體素關聯一個整數 v(r):
把這一步在真實資料上跑出來,是這個樣子:
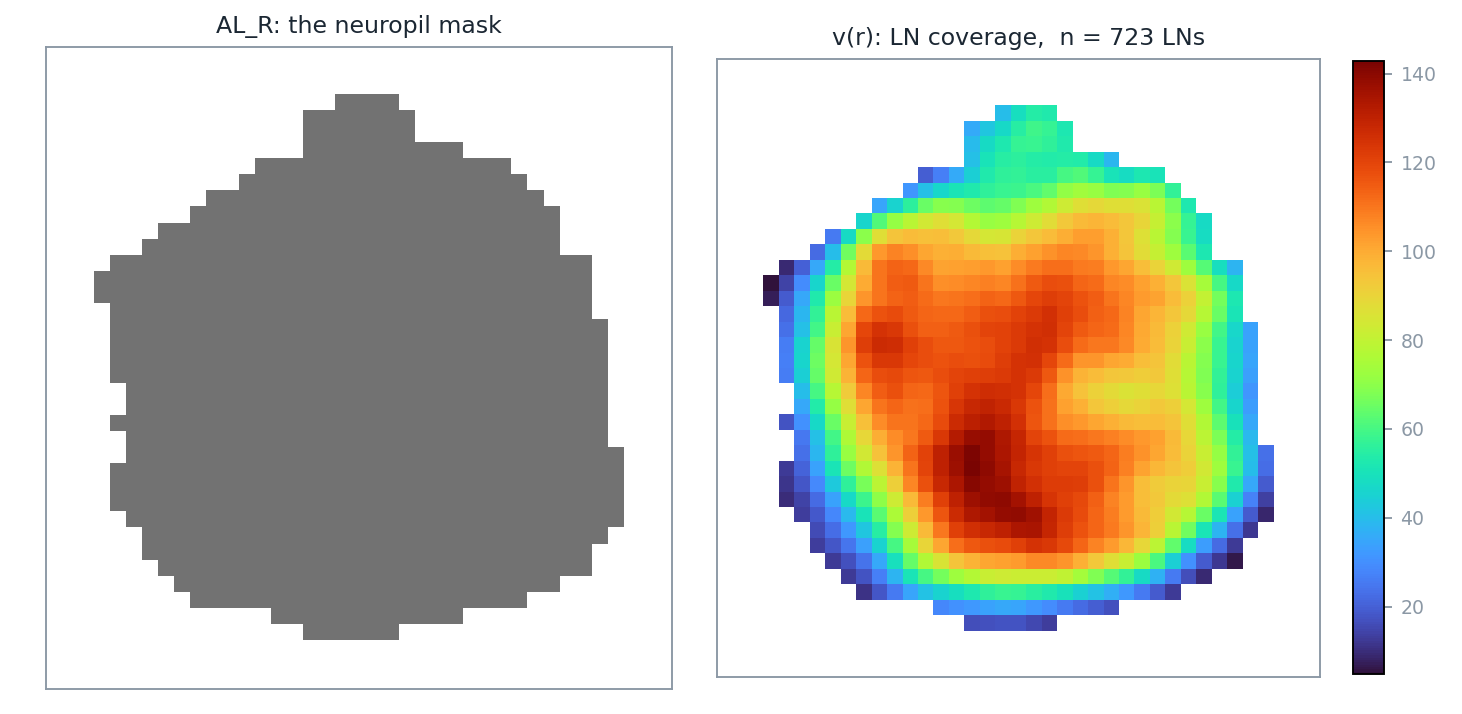
v(r),紅色是密、藍色是疏。可以看出密度不是平均分布的——這正是後面幾步要利用的訊息。
由 scripts/make_part2_figures.py 算出。我們那張 AL_R 密度圖做了論文沒做的事
上面那張 AL_R 的密度圖,除了論文那個 3×3×3 的平均,還先做了一次真正的併格:make_part2_figures.py 裡 B = 4,把 4×4×4 個標籤格(1 µm)併成一個分析體素(4 µm),格數變成原本的 1/64。
理由是 STEP 3 的距離矩陣——不併格的話,熱點體素數乘進 N(N−1)/2 會直接超出記憶體——不併格的話光距離矩陣就要 110 GB(下面 STEP 3 會再談這件事)。這是我們的工程妥協,不是論文的步驟。代價是:小於一個分析體素的密度結構,在我們的圖上根本不會出現。所以我們掃切割高度掃出來的那些數字,也要放在這個尺度下讀。
實作上的第一個分岔:v(r) 到底在數什麼
論文在三個地方寫這一步,用了三種說法:
· 正文的七步驟條列第 (1) 步:calculating the number of counts passing through a voxel by populations of LNs(數「LN 族群穿過該體素的次數」)
· 補充材料〈Defining an LPU〉:the number of LN fibers passing through the voxel(穿過該體素的纖維條數)
· 圖 S5D(b) 的圖說:the number of repetitive registrations of every single voxel(該體素被重複註冊的次數)
後兩者不是同一件事。「一顆神經元的三條分枝都穿過同一個體素」在「纖維條數」算 3、在「重複註冊次數」算 1。正文那句沒有裁決——它只說「數次數」,沒說數的是纖維還是神經元。而我們手上的資料是二值化的——每一格只記「有沒有被這顆神經元佔到」,不記亮度、也不記裡面有幾條纖維(D06 的骨架體素就是這樣存的)。從這種資料你只做得到「重複註冊次數」那一個,因為「同一格裡有三條分枝」這件事根本沒有被記下來。
本頁採用的就是它:同一顆神經元在同一個分析體素裡,不論留下幾筆紀錄都只算一次。換句話說,v(r) 是「有幾顆不同的 LN 佔到這一格」。右觸角葉的 v(r) 因此最大 142.8、平均 65.7。PART 3 的指令、PART 4 的實跑、PART 5 的程式(lpu_lib.py 的 density_field())用的都是同一個定義,所以四頁的數字可以逐項對照。
換成另一種算法會差多少,量過了。先把三個容易混在一起的尺度講清楚:
| 格子 | 邊長 | 是什麼 |
|---|---|---|
| 標籤格 | 1 µm | D03 分區檔的格子,腦區的邊界畫在這上面 |
| D06 的骨架體素 | 2 個標籤格=2 µm | 神經元骨架存在這上面:「某顆神經元經過某個體素」一筆 |
| 分析體素 | 4 個標籤格=4 µm | 本頁把 4×4×4 個標籤格併成一個,v(r) 與後面的分群都在這上面做(見上面〈我們那張 AL_R 密度圖做了論文沒做的事〉) |
所以一個分析體素裝得下 8 個 D06 體素(2×2×2)。同一顆神經元穿過一個分析體素時,往往在裡面留下好幾筆紀錄——右觸角葉實測平均 1.44 筆、最多 7 筆。
如果 v(r) 改成「每一筆(體素, 神經元)紀錄都加 1」,這些重複就會被重複計入,v(r) 的最大值從 142.8 變成 206.6。但兩種算法只差在絕對值:
- 在右觸角葉區內 12,511 個分析體素上,兩者的排序相關是 0.998(誰比誰密,幾乎完全一致)。
- 熱點集合幾乎是同一批:兩種算法各自取自己的上四分位,新定義留下 3,130 個體素、舊定義 3,128 個,交集 3,027、聯集 3,231 —— 3,027 ÷ 3,231 = 94%。(這種「交集除以聯集」的算法叫 Jaccard,兩個集合完全相同是 1、完全沒交集是 0。)
- 下面〈STEP 3〉那個切割高度 14–20 的平台(平台=曲線上一段「高度再怎麼調、體素順序再怎麼打亂,答案都不變」的區間),兩種算法給出的群數完全相同。
絕對值會變,判定不會。
STEP 2取上四分位,留下熱點
這一步是對單一個 neuropil 做的:把那個 neuropil 內所有的 v(r) 拿來做五數綜合(five-number summary:最小值、下四分位、中位數、上四分位、最大值)。取上四分位 QU,定義熱點集合:
上四分位就是把所有數字由小排到大之後,位在 75% 那個位置的值。有些書叫它「第三四分位」或 Q3,是同一個東西;本頁一律用「上四分位」,因為論文用的是 upper quartile(QU)。
論文沒有說明為什麼選四分位,不過用四分位而不是一個固定的數字,效果是看得見的:門檻是每個腦區各自算的,所以不論哪一區、LN 有多少顆,都恰好留下自己最密的四分之一。我們在六個腦區上實測,留下的比例是 25.0%–25.1%——這是四分位的定義使然,不是巧合。
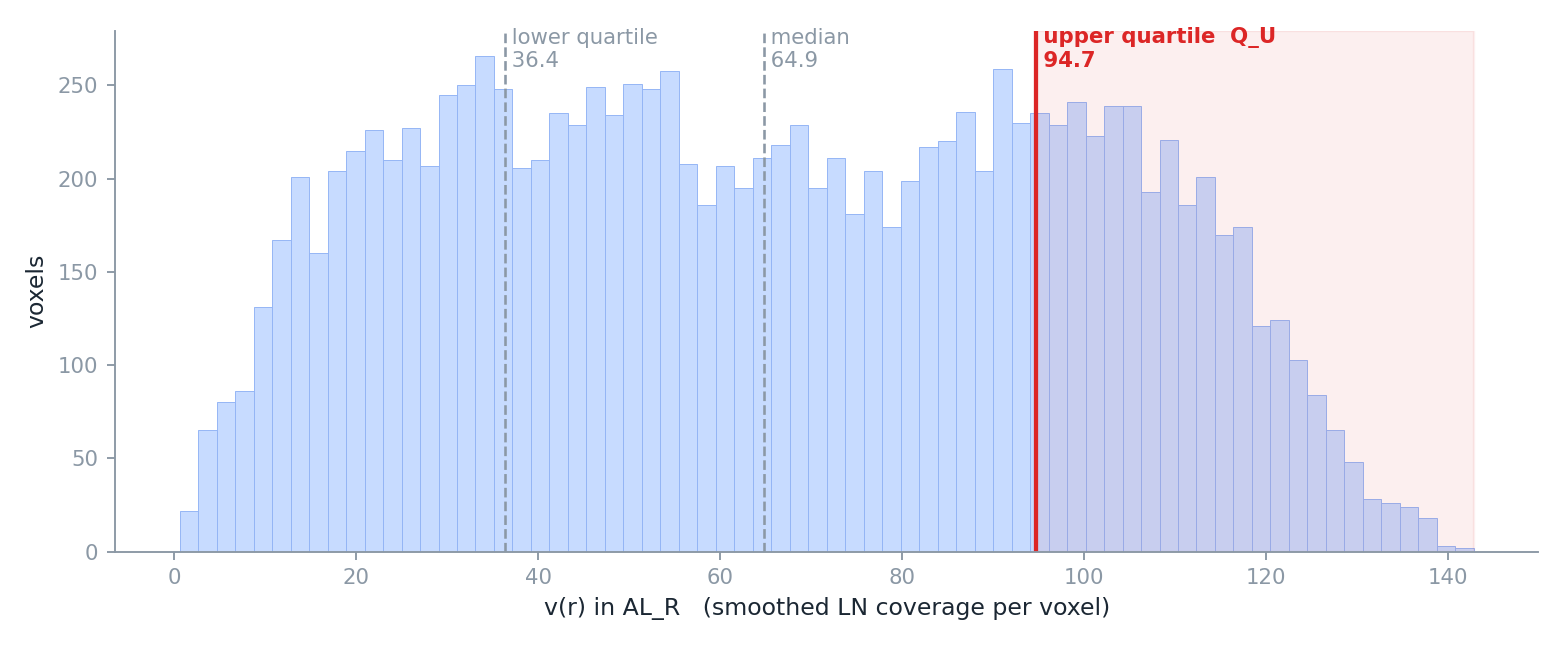
QU = 94.7,右邊那塊淡紅色區域就是熱點集合 Z。
由 scripts/make_part2_figures.py 算出。STEP 3分群——兩條規則要一起用
這一步要做的事:把 STEP 2 留下的那堆熱點體素分成幾團,看這個腦區裡有幾處「各自密集」的地方。一團就是一個候選 LPU。
要分群,得先知道任兩個體素離多遠。對 Z 裡的體素兩兩算歐氏距離,構成距離矩陣:
| 規則 | 出處 | |
|---|---|---|
| ① | 把 UPGMA 的樹剪在某個高度——剪出幾枝,就有幾群 | 論文沒有給這個高度 |
| ② | 只留體素數大於「該 neuropil 總體素的 1%」的群 | 論文明寫:Those clusters with voxel numbers larger than 1% of the total voxel number in the neuropil are LPU candidates |
兩條缺一不可,而且會互相牽制。剪得越細,群越多但每一群越小、越容易被規則 ② 刷掉;剪得越粗,群越少但每一群都過得了。下面會看到這個交互作用直接決定了答案。
v(r) 只形成一群,那麼這個 neuropil 本身就是一個完整的 LPU,不需要再細分。否則,每一群各自成為一個候選 LPU。論文寫「多數解剖學上劃好的 neuropil 都符合 LPU 的條件」,又寫「In only one case (i.e., VLP), we found two LPUs in one neuropil」——兩句合起來看,全腦幾乎都走了前一條路。(嚴格說,論文沒有逐區交代誰在哪一步被判成一群,這是從這兩句推的。)
體素在整齊的格點上,所以距離會大量重複
體素不是散落在空間裡的點,它們排在一個規則的立方格點上。兩個體素的距離只能是 √(a²+b²+c²) 這種形式,a、b、c 都是整數——可能的值本來就不多。
| 右觸角葉的熱點 | |
|---|---|
| 體素數 | 3,130 |
| 配對數(距離矩陣的長度) | 4,896,885 |
| 相異的距離值 | 557 |
| 平均每個距離值被幾對共用 | 8,792 |
先記著這件事。分群演算法每一步都要挑「最近的一對」,而這裡有成千上萬對並列第一——下面〈平手的時候,UPGMA 挑誰?〉會看到它造成什麼後果。
再用 UPGMA(unweighted pair group method with arithmetic mean,中譯「不加權平均連結法」)把體素分群(規則 ①),再把體素數不到該 neuropil 總體素 1% 的群丟掉(規則 ②),剩下的才算候選 LPU。
它不是「合併 8 次」。以右觸角葉為例,3,130 個熱點體素要全部併完需要 3,129 次合併;剪在高度 8,實際上已經做掉 3,125 次,只剩下 5 群。而第 8 次合併發生在高度 1.00——離 8 還很遠。
| 切割高度 | 已經做掉的合併次數 | 剩下的群數 |
|---|---|---|
| 1 | 1,517 | 1,613 |
| 2 | 2,770 | 360 |
| 4 | 3,080 | 50 |
| 8 | 3,125 | 5 |
| 14 | 3,129(全部) | 1 |
高度的單位就是體素——這裡是分析體素(4×4×4 個原本的體素併成一個)。所以「高度 8」大致是「兩群的平均距離在 8 個分析體素以內」。
兩條規則怎麼互相牽制
把右觸角葉的每一個切割高度攤開,分別看「樹剪出幾群」與「有幾群過得了 1%」:
| 切割高度 | 規則 ① 剪出的群數 | 規則 ② 通過的群數 (=候選 LPU) | 最大的一群有多少體素 (門檻是 125) |
|---|---|---|---|
| 4 | 50 | 0 | 114 ← 連最大的都不到 125 |
| 5 | 28 | 9 | 185 |
| 6 | 16 | 14 | 299 |
| 8 | 5 | 5 | 1,011 |
| 10 | 4 | 4 | 1,144 |
| 14 | 1 | 1 | 3,130 |
高度 5、6 是兩條規則同時在起作用的一段:高度 5 剪出 28 群、只有 9 群過關,被丟掉的體素佔了熱點的 56.5%;高度 6 剪出 16 群、過 14 群。高度 7 以後規則 ② 就不再刷掉任何東西了——群夠大,全部通過,答案完全由規則 ① 決定。
scipy 的作法是挑索引最小的那一對,也就是按你輸入體素的先後順序。
這不是無關痛癢的細節。把同一批體素打亂順序重跑,答案就變:右觸角葉在切割高度 6,九次打亂給出的是 13、13、13、14、14、14、15、15、15——從 13 到 15 都有。同一份資料、同一個參數,只有列的順序不同。
一、換一種連結法。「連結法」不是某個方法的名字,而是分群時的一個選項:兩群之間有很多條配對距離,要拿哪一條當作「這兩群的距離」。UPGMA 用的是平均(所有配對的平均),另外兩種常見的選擇是單一(取最近的一對)與完全(取最遠的一對)。改用單一連結就沒有平手問題,但在這裡完全沒有分辨力(下一節〈什麼是「連結法」〉細講)。
二、報範圍,不報單一數字。打亂順序跑幾次,把最小到最大一起呈現。下面那張切割高度掃描圖就是這樣畫的。
三、只採信打亂之後不變的結論。切割高度掃描圖上帶寬為 0 的區段才算數;帶寬張開的地方,那個數字不是資料告訴你的。
什麼是「連結法」,為什麼換一種就沒有平手問題
UPGMA 每一步要挑「最近的兩群」併起來。但兩群之間的距離是什麼?群裡有很多個體素,體素跟體素之間有很多條距離——要拿哪一條當作「這兩群的距離」?
這個選擇就叫連結法(linkage)。常見的有三種:
· 單一連結=「只要有一個人同時認識兩邊,就算同一群」。
· 平均連結=「兩邊平均要夠熟才算同一群」。
· 完全連結=「要每個人都跟對面每個人都熟才算」。
為什麼單一連結不怕平手
因為它的答案根本不用管合併順序。在高度 h 剪斷單一連結的樹,得到的東西可以用另一種方式一次算出來:
h 的體素兩兩連起來,看形成幾塊連得通的
兩個體素只要能經由一連串「每步都 ≤ h」的中繼點走到彼此,就屬於同一塊。
平均連結不一樣:A 和 B 一旦併起來,這個新群到 C 的平均距離就變了。所以先併哪一對,會改變後面每一步看到的數字。這就是平手為什麼會影響結果。
我們實際驗過這個等價關係——單一連結剪在高度 h,跟直接算「距離 ≤ h 的連通塊」,在 h = 0.9、1、1.5、2、3、6 上都給出同一個數。
那為什麼不乾脆用單一連結
因為它在這裡什麼都分不出來。熱點體素排在格點上,彼此正好相鄰(距離 = 1)。只要允許「相鄰就連起來」,3,130 個熱點體素立刻全部串成一整塊。
| 切割高度 | 單一連結給出的群數 |
|---|---|
| 0.9(連相鄰都不算) | 3,130 ← 每個體素自成一群 |
| 1.0 以上 | 1 |
結論:單一連結可重現,但沒有分辨力;平均連結有分辨力,但答案受順序影響。論文選了後者,所以就得面對前面那個平手問題。
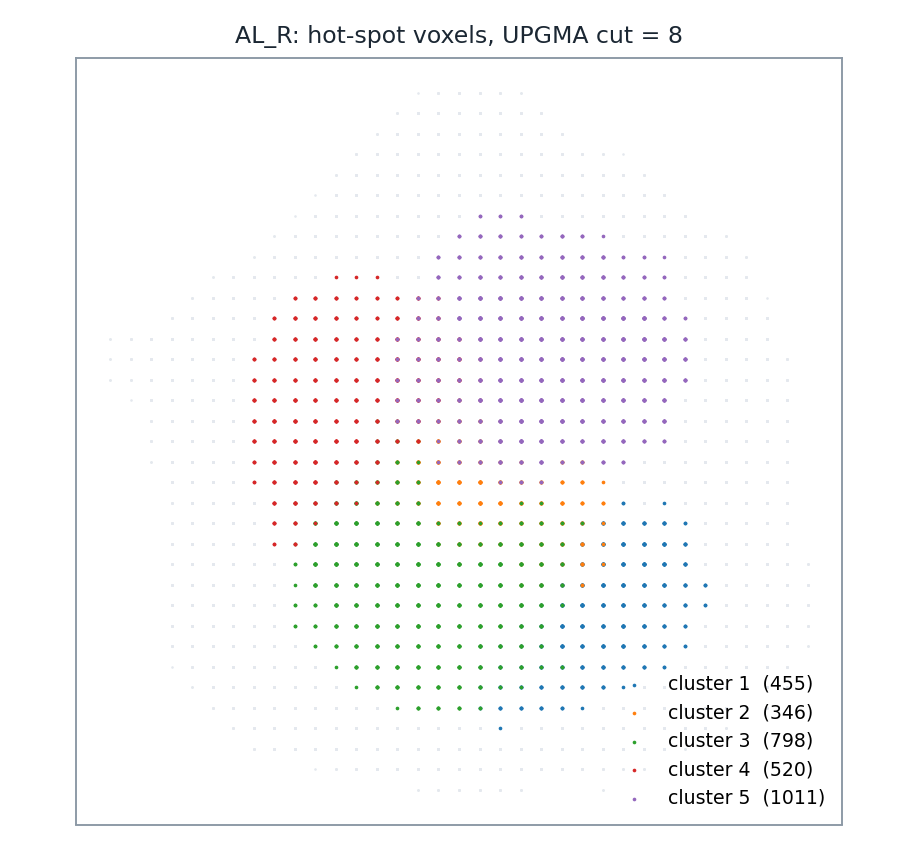
scripts/make_part2_figures.py 算出。規則 ① 的高度,論文沒有給
兩條規則裡,規則 ② 的 1% 論文寫得清清楚楚,規則 ① 的高度卻從頭到尾沒有出現。這是整條流程最大的空缺——而上面〈兩條規則怎麼互相牽制〉那張表已經顯示,高度從 4 動到 6,答案就從 0 跳到 14。
這不是雞蛋裡挑骨頭。我們把六個腦區的切割高度從 4 掃到 25,看每個高度會得到幾個候選 LPU:
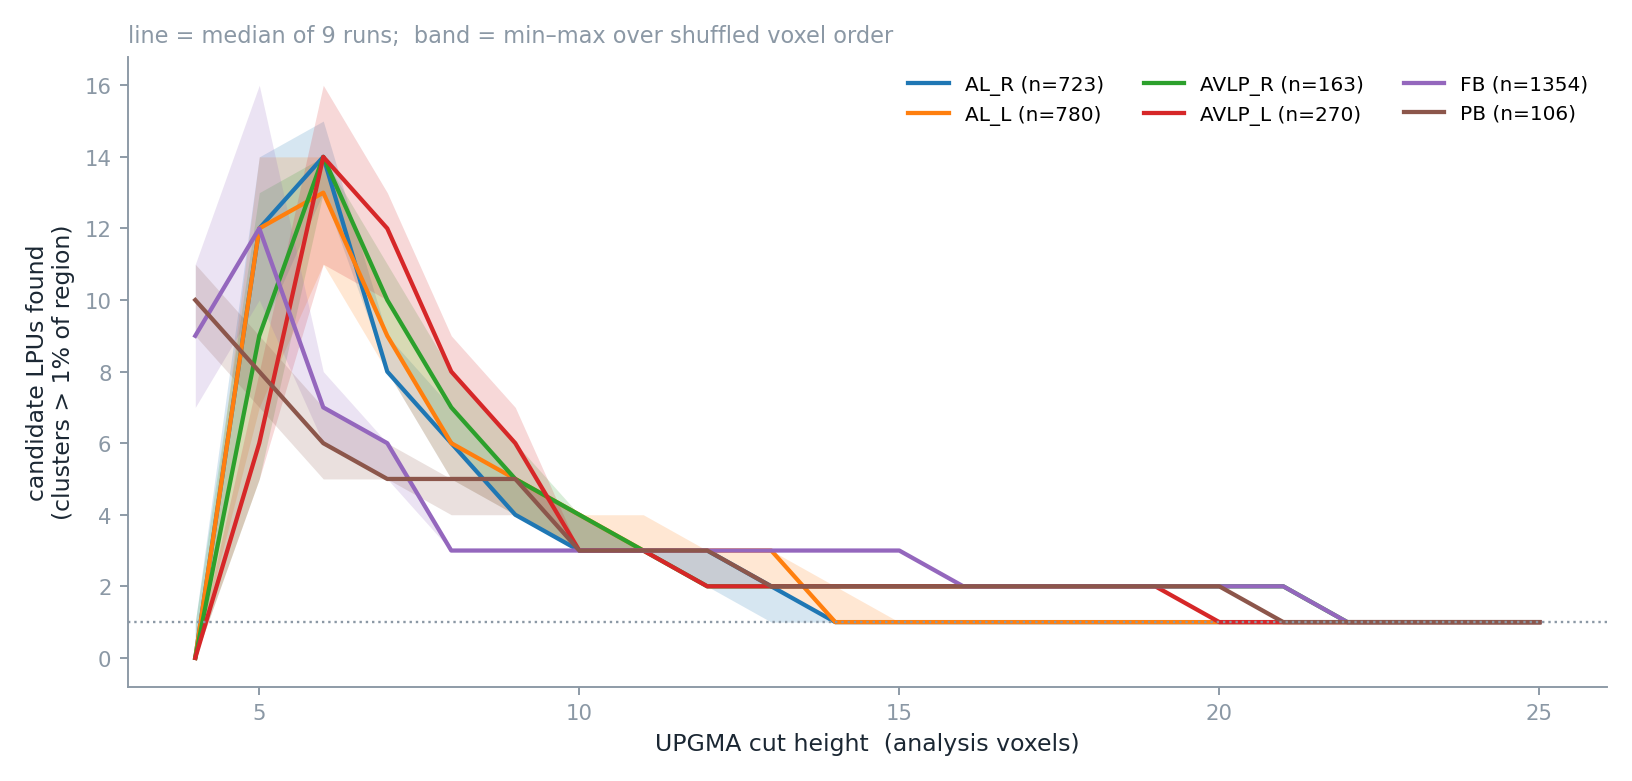
scripts/make_part2_figures.py 算出,資料同前。| 腦區 | LN 候選數 | 候選 LPU 數的範圍 (高度 4–25 × 九次打亂) |
|---|---|---|
| AL_R(右觸角葉) | 723 | 0 – 15 |
| AL_L(左觸角葉) | 780 | 0 – 14 |
| AVLP_R | 163 | 0 – 14 |
| AVLP_L | 270 | 0 – 16 |
| FB(扇形體) | 1,354 | 1 – 16 |
| PB(前腦橋) | 106 | 1 – 11 |
曲線中段確實有平台——一段高度再怎麼調、答案都不變的區間,而且帶寬是 0(打亂體素順序也不變)。但每個腦區的平台高度不一樣。切割高度 14 到 20 這一段是最穩的:
| 切割高度 14–20 | AL_R | AL_L | AVLP_R | AVLP_L | FB | PB |
|---|---|---|---|---|---|---|
| 候選 LPU 數 | 1 | 1–2 | 2 | 1–2 | 2–3 | 2 |
(表上的範圍已經把九次打亂算進去了。)先說清楚論文對這六個區的說法:觸角葉、扇形體、前腦橋在論文裡都是單一 LPU;而 AVLP 不能這樣講——它屬於 Chiang 的 VLP,那正是論文全篇唯一被切成兩個 LPU 的腦區(背側與腹側)。
於是這個平台上,觸角葉本該是 1 卻只有右側穩定給 1、扇形體與前腦橋本該是 1 卻給 2–3。沒有一個切割高度能讓這四個區同時回到 1。
而右邊那段「全部收斂到 1」根本不是結論。每一棵樹都有一個最高點——根,也就是最後一次合併的高度。剪在根以上,當然只剩一群:
| 腦區 | AL_R | AL_L | AVLP_R | AVLP_L | FB | PB |
|---|---|---|---|---|---|---|
| 整棵樹的高度(根) | 13.1 | 13.5 | 21.2 | 19.4 | 21.9 | 20.8 |
六棵樹的根都在 22 以下。所以「高度 22 以上六個區都給 1」只是「22 超過了每一棵樹的頂端」——那是算術,不是資料在告訴你這六個區各是一個 LPU。
scipy 的 pdist 回傳 float64,等於 37 GB(就算改成 float32 也還要 19 GB)。動手前先算一次規模。
STEP 4從一顆 LN 開始滾雪球
這一步要做什麼,論文說得很清楚:把屬於這個候選 LPU 的 LN 全部收集起來。正文第四步的標題是「recruiting LNs into each subdivision」(把 LN 招募進每一個細分區);補充材料則說被招募的神經元「designated as building blocks for the candidate LPU」——它們就是這個候選 LPU 的組成單位,而下一步的邊界就是繞著它們畫出來的。
作法是:在最小的候選 LPU 裡,用目視挑一顆纖維侷限在該候選 LPU 內、體積最小的 LN 當作起始的種子(論文的原字是 initial source)。接著:
- 被檢查的那一顆 LN——論文叫它 target(a target neuron is recruited if over 50% of its volume overlaps with the source)。50% 的分母就是它的體積。
- 被拿來比對的那一團——論文叫它 source。本專題把這一團叫「靶」,因為它才是「落在誰裡面」的那個「誰」。(注意:本專題的「靶」=論文的 source,不是論文的 target。論文的 target 是上面那顆被檢查的 LN。)
被撐大的只有那一團(source),被檢查的那顆 LN 不撐大——這是我們的實作選擇,理由與論文原文(all voxel units enlarged,兩邊都撐大)的差別,見下面〈六個要注意的地方〉的第一點(「放大」該怎麼讀)與第四點(50% 的分母是哪一個)。
| 補充材料的寫法(滾雪球) | 圖 S5D(e) 圖說的寫法(固定靶) | |
|---|---|---|
| 那一團是什麼 | 起始的那顆種子,加上已經收進來的每一顆 LN | STEP 3 分出來的那一群熱點體素 |
| 它會不會變 | 會。每收一顆就把它併進來,下一輪再撐大一次——愈滾愈大 原文:Once recruited, two partners are combined as a new source for recruiting next target | 不會,從頭到尾就是那一群。每顆 LN 各量一次「我有多少比例落在這一群裡」,超過門檻就收 原文:candidate LNs recruited based on the coverage of the two clusters |
| 有沒有回饋 | 有。先收到誰,會改變接下來收得到誰 | 沒有。每顆各算各的,互不影響 |
「種子」與「靶」在滾雪球這一種讀法裡會合流:一開始那一團就只有種子,收了第一顆之後,那一團=種子+第一顆,再往下就愈滾愈大。固定靶那一種沒有種子這個角色——不必挑起點,因為那一群本來就在。
選哪一種不是文字之爭,它決定這一步跑不跑得動:滾雪球那一種在三個腦區、388 組參數下(右觸角葉 20 組,前腦橋與 AVLP_R 的四個群各 92 組),結果不是「只有種子」就是「幾乎整池全收」,沒有一組落在中間——因為每收一顆就把靶放大一次,只有「收不到」與「全收」兩個終點;固定靶那一種則隨門檻連續變化。PART 4〈發現一〉把兩種讀法都跑了一遍。
六個要注意的地方
一、「放大」不能照字面理解成「把整個座標放大」。如果是整體等比放大,這一步不會有任何作用——判準是「重疊超過體積的 50%」,是一個比例;把所有東西一起放大 4 倍,分子分母同時變大,比例一模一樣。
唯一說得通的讀法是把神經元佔用的那些體素各自向外撐大(影像處理裡叫形態學膨脹)。
換句話說,被撐大的是神經元的形狀,不是格子。格點位置、格子大小都沒有動;動的是「這顆神經元佔了哪些格」——原本只佔一條細線,撐大之後佔了一條粗一點的管。原文寫 all voxel units enlarged,字面是「所有體素單位」——但有作用的只有被神經元佔用的那些。
二、先講清楚這裡的「重疊」是什麼。比的是兩顆神經元,但度量單位是體素:
所以這一步量的是「兩顆神經元佔不佔同一塊地盤」,不是「它們有沒有接觸」。用在這裡是恰當的——STEP 4 要找的本來就是「纏在同一個區域裡的那一群 LN」,不是連結關係。但這個數字不能拿去當接觸或突觸的證據(PART 1 第 8 節談的正是這件事)。
三、不膨脹的話,這一步根本跑不動。拿右觸角葉的 LN 候選抽 60 顆,按上面的定義算:
| 每個含神經元的體素向外撐大 | 有交集的配對 | 重疊率中位數 | 最大重疊率 | 超過 50% 的配對 |
|---|---|---|---|---|
| 0 格(不膨脹) | 96.4% | 0.015 | 0.10 | 0.00% |
| 1 格 | 99.6% | 0.092 | 0.35 | 0.00% |
| 2 格 | 100% | 0.238 | 0.68 | 5.9% |
| 3 格 | 100% | 0.398 | 0.90 | 35.2% |
| 4 格 | 100% | 0.531 | 0.96 | 53.4% ← 管線實際採用 |
不膨脹時最大的重疊率只有 0.10,沒有任何一對過得了 50% 的門檻——雪球一顆都招募不到,STEP 4 當場停住。膨脹不是在微調結果,是在讓這個步驟成立。
管線最後用 4 格,也是被這張表逼出來的:撐大 2 格只有 5.9% 的配對過門檻,PART 4 實測在右觸角葉上一顆都招不到;撐大到 4 格才有 53.4%——但那之後雪球又三輪吞下全部 723 顆。兩個極端之間沒有中間值,這正是滾雪球讀法的問題。
因為格子不是被「分配」掉的。如果體素像拼圖,一格屬於一顆神經元,那確實不可能重疊。但實際的流程不是這樣:
每一顆神經元是單獨造影、單獨追蹤骨架,再各自映到同一個標準腦的格點上。每顆神經元因此產生自己的一份體素名單。從頭到尾沒有任何一步把某一格指派給某一顆神經元——所以同一個格子編號,會同時出現在很多顆神經元的名單裡。
像把 723 張透明片各畫一條線,疊在同一張方格紙上。任何一格都可能有好幾張片子的墨水,因為方格紙沒有把格子分給任何一張片子。
| D06 全腦 28,573 顆神經元 | |
|---|---|
| (體素, 神經元)紀錄 | 11,895,201 筆 |
| 相異的體素 | 3,365,959 個 |
| 平均每個體素被幾顆神經元登記 | 3.5 |
| 最擠的一個體素被幾顆登記 | 67 |
資料結構本身就看得出來:D06 存的是一份(體素, 神經元)的配對清單,同一個體素編號在裡面重複出現很多次。1,189 萬筆紀錄,只落在 337 萬個相異體素上。
至於為什麼那麼多纖維會落到同一格:因為一格比一條纖維粗得多。D06 的體素邊長是 2 個座標格(約 0.8–1.25 真實微米),而果蠅的神經纖維直徑常在 1 微米以下——同一個立方格裡塞得下好幾條不同神經元的纖維。
回到右觸角葉那 723 顆 LN 候選,它們佔用了 141,327 個相異體素:
| 被幾顆神經元佔用 | 體素數 | 佔比 |
|---|---|---|
| 只有 1 顆 | 27,366 | 19.4% |
| 2 顆以上 | 113,961 | 80.6% |
| 10 顆以上 | 59,624 | 42.2% |
中位數是 7 顆神經元共用一格,最擠的一格被 46 顆佔用。
所以膨脹要解決的不是「完全沒有交集」,而是「交集太小」。兩顆神經元各自的分枝鋪得很開,真正重疊的只是其中一小塊——不膨脹時任意兩顆的重疊率中位只有 1.5%、最大 10%,離 50% 的門檻很遠。把神經元佔的每個體素撐大,等於把「算是重疊」的範圍放寬,那一小塊才長得到過門檻的大小。
以上都在我們的資料上量的(D06 骨架體素),程式在 scripts/dilation_check.py。論文用的是原始共軛焦影像,體素更細、絕對數字會不同。
四、「所有體素」已經回答了撐大誰——但沒回答 50% 的分母是哪一個。論文的原句是 With all voxel units enlarged 4 folds, a target neuron is recruited if over 50% of its volume overlaps with the source.「所有」表示 source 與 target 兩邊都撐大。沒有交代的是後半句那個 its volume:50% 的分母,是 target 撐大前的體積,還是撐大後的?這個差別大到會讓其中一種讀法直接不成立:
| 讀法 | 撐大誰 | 50% 的分母 | 重疊率中位數 | 超過 50% 的配對 |
|---|---|---|---|---|
| ① | 只撐大 source | target 撐大前的體積 (target 根本沒撐大) | 0.238 | 5.9% ← 本專題採用 |
| ② | 只撐大 target | target 撐大後的體積 | 0.227 | 19.8% |
| ③ | 兩邊都撐大 | target 撐大前的體積 | 3.26 ← 超過 1 | 93.6% |
| ④ | 兩邊都撐大 | target 撐大後的體積 | 0.232 | 4.0% ← 論文的字面讀法 |
為什麼會跑出這種數字:分子分母不是同一個東西。分子數的是「撐大後的 A 與撐大後的 B 共同佔到的格子」,分母卻用「撐大前的 B 有幾格」。B 撐大兩格之後體積變成原本的 16.9 倍,所以共同的部分輕易就比原本的 B 大好幾倍。要嘛分子分母都用撐大後的(那就是第 ④ 列,0.232),要嘛都用撐大前的(那就是不膨脹,0.015)——不能一邊撐大一邊不撐。
照字面讀,成立的是第 ④ 列:兩邊都撐大、分母也用撐大後的體積。第 ③ 列不成立(比例大於 1),第 ② 列不是論文的讀法。
recruit(),用的都是第 ① 列。
為什麼不用第 ④ 列:滾雪球時 source 每一輪都在長大,若 target 也要撐大,每一輪都得把每一顆候選神經元重新撐大一次;只撐大 source 則每輪只撐一次。
代價量過了:第 ① 列與第 ④ 列的通過率是 5.9% 對 4.0%,中位數 0.238 對 0.232——兩者很接近。真正會翻盤的是第 ③ 列(93.6%),而那個讀法本身不成立。換句話說,這個簡化沒有把門檻放鬆到改變結論的程度,但它仍然是我們的選擇,不是論文的規定。
五、「4 倍」是每個方向 4 倍,還是體積 4 倍?兩種讀法差 16 倍。而在體素格點上還有第三個問題:撐大是一格一格來的,跨不出小數。
| 神經元的體素向外撐大 | 1 格 | 2 格 | 3 格 | 4 格 |
|---|---|---|---|---|
| 體積變成幾倍(我們抽的 60 顆 LN 的中位數) | 6.2 | 16.9 | 29.7 | 41.0 |
撐大一格,體積就跳到 6.2 倍——「體積 ×4」這個讀法在格點上跨不過去。
| 形狀 | 撐大 1 格後體積變成幾倍 |
|---|---|
| 孤立的單一體素 | 7.0 |
| 一條一格寬的直線 | 5.0 |
| 實心立方體 4×4×4 | 2.5 |
| 實心立方體 8×8×8 | 1.8 |
| 實心立方體 16×16×16 | 1.4 |
| 實心立方體 32×32×32 | 1.2 |
神經元的骨架在這個解析度下幾乎就是「一格寬的分枝曲線」——每一個體素都在表面上,所以倍率落在「直線 5.0」與「孤立體素 7.0」之間,大約 6。分枝點與斷點把它往 7 推,筆直的段落把它往 5 拉。
實測三個腦區各抽 60 顆,倍率確實都擠在一起:AL_R 4.3–6.6(中位 6.2)、FB 5.9–6.6、PB 5.9–6.7。所以在這份資料上「撐大一格 ≈ 六倍體積」是穩的,但別把它當成一條通則搬到別的東西上——換成實心的區塊,撐大一格連兩倍都不到。
論文沒有給這個 4 的推導——enlarged 4 folds 全文只出現這一次。論文有說整個招募在做什麼(見上面的引文),沒說的是這個 4 從哪裡來、以及它對應到格點上的哪一步。
六、種子的條件挑不挑得出合格的神經元,要看腦區。論文寫「a smallest LN with its fibers restricted within the smallest candidate LPU」——纖維要完全侷限在那個候選 LPU 之內。在右觸角葉、切割高度 8 分出來的那幾群上,照字面一顆都挑不到:
| 右觸角葉 723 顆 LN 候選,各有多少比例的體素落在…… | 中位數 | 最大值 | 達到 100% 的 |
|---|---|---|---|
| 最小的那一群(切割高度 8,346 個體素) | 4.5% | 23.6% | 0 顆 |
| 全部熱點體素(五群加起來) | 39.6% | 77.2% | 0 顆 |
| 整個右觸角葉 | 92.1% | 99.5% | 0 顆 |
照字面找,一顆都找不到——最接近的那顆也只有 23.6% 的體素落在最小那一群裡。把該群膨脹兩格、再填洞(把區域內部剩下的小空洞補起來)放寬,最好的一顆升到 46.9%,達到 100% 的還是 0 顆(scripts/seed_check.py)。要讓這一步跑起來,只能改成「有一部分落在裡面就算」,而「一部分」是多少,論文沒有給。
但換一個腦區,這個條件就成立了。在 AVLP_R、切割高度取平台上的 17 時,最大的那一群裡有五顆 LN 的體素有 97% 以上落在群內,最高的一顆是 99.1%(該顆共 112 個分析體素,不是小到失真的個案)。所以「挑不到合格的種子」是右觸角葉這個腦區的性質,不是這個條件本身的性質。真正沒有給的是另一件事:當一個腦區裡一顆合格的都沒有時該怎麼辦。
再加上論文明寫這一顆是目視決定的——這是整條流程唯一寫明要人介入的一步,而換一顆種子,招募出來的結果可能不同。
STEP 5抽等值面,定出邊界
把所有被招募的 LN 疊在一起,去掉它們的初級神經突(primary neurite)與細胞本體(soma),再對剩下的纖維密度場取等值面——這個曲面就是候選 LPU 的估計邊界。
為什麼要去掉細胞本體與初級神經突
論文在這一步沒有給理由(原句就是 after removing their primary neurites and soma,沒有下文)。但理由在解剖學上很清楚,而且可以量出來。
論文自己的圖說給了一個例子:某一群神經元「Their cell bodies are located in the ventral brain, and their primary neurites (arrows) project dorsally along the brain midline」——細胞本體在腹側,初級神經突卻沿著腦的中線一路往背側走。這一段路橫跨了好幾個腦區,但它在每一區都只是路過。
把它們留著會怎樣?密度場會在腦區外面多出一團,等值面跟著被拉出去,算出來的「候選 LPU 邊界」就不再是那個腦區的形狀了。這件事在我們的資料上看得很清楚:
| 離細胞本體的路徑深度 沿著骨架走幾步,不是直線距離 | 體素數 | 落在右觸角葉之外 | 落在任何腦區之外 |
|---|---|---|---|
| 0–5(最靠近本體) | 4,271 | 63.2% | 61.7% |
| 5–10 | 5,647 | 39.0% | 37.4% |
| 10–20 | 22,581 | 15.2% | 13.2% |
| 20–35 | 100,280 | 7.9% | 4.9% |
| 35–65(中段) | 614,497 | 8.0% | 5.3% |
| 65–100(末梢) | 549,195 | 17.1% | 13.0% |
scripts/neurite_check.py)
順帶一提,論文在別處也是這樣處理的:FlyCircuit 的空間分布分析「the soma was excluded」,圖 S2 的圖說也註明「The soma was excluded」。細胞本體被排除是這套資料的慣例;初級神經突則是在 LPU 這一步才額外去掉的。
又一個沒給的參數
等值面的門檻要設多少,論文沒有寫(isointensity surface 只有名字,沒有數值)。而它直接決定候選 LPU 的體積——也就直接影響下一步的 c 值。
差多少?量給你看。同一批神經元(右觸角葉招募到的 723 顆,去掉初級神經突之後),只換這一個門檻:
| 門檻取密度的第幾百分位 | 抽出來的區域佔腦區 | 下一步的 c 值 | 過得了 c > 2 嗎 |
|---|---|---|---|
| 10 | 373.7% | 248.9 | 過 |
| 25 | 283.0% | 99.2 | 過 |
| 50 | 187.2% | 24.9 | 過 |
| 75 ← 本專題採用 | 93.4% | 2.67 | 過 |
| 90 | 37.4% | 1.22 | 不過 |
c 值從 248.9 掉到 1.22——205 倍,而且中途跨過了 c > 2 這條判準。前三個門檻抽出來的「候選 LPU」甚至比腦區本身還大(密度場會溢出到區外,因為被招募的神經元有一部分伸出去了)。第 75 百分位是這幾個裡唯一讓區域小於腦區的,本專題後面一律用它——那是我們挑的,不是論文給的。由 part5/lpu_lib.py 的 c_value() 算出。
STEP 6算 c 值:中心要比周邊密
一個真正的 LPU,其 LN 纖維應該中間密、周邊相對空(論文說膠質細胞鞘可能也有貢獻)。把候選 LPU 的表面均勻內縮,使內部恰好包含 80% 的體素,記為中心區 A,其餘為周邊區 B。定義:
公式看起來複雜,是因為它把兩個平均寫成了一個分數。中心的平均密度是 ΣAv ÷ NA,周邊的是 ΣBv ÷ NB,兩者相除,分母的 N 就跑到分子去了。c > 2 的意思就是:中心的平均密度要在周邊的兩倍以上。
STEP 7驗證:有沒有自己的長程神經束
最後一步是查這個候選區域有沒有自己的長程神經束。
一個腦區就算內部再緊密,如果沒有任何一束纖維把它接到別的地方,它就只是一團組織,不是處理單元——沒有輸入、也沒有輸出。所以 LPU 的兩個條件是「對內有自己的班底」加上「對外有專線」,缺一不可。
一句常被誤引的話
「一條神經束至少由三顆神經元組成」不是論文的定義,也不是演算法的條件。它只出現在圖 7D 與圖 S7 的圖說裡,是在描述他們找到的那些神經束的性質:Each tract is composed of at least three neurons and may actually link more than two LPUs。
論文真正用來把纖維綁成一束的演算法寫在補充材料〈Searching Neural Tracts〉,判準是兩個門檻:兩端的平均終點位置相距小於 30 個體素,且總路徑長度的相似度大於 60%。裡面沒有任何「至少三顆」的規則。
| 有自己的 LN 族群 | 有自己的長程神經束 | 判定 |
|---|---|---|
| 是,而且 c > 2 | 是 | LPU |
| 沒有 LN 族群(c 根本算不出來) | 是 | hub |
| 是,而且 c > 2 | 否 | 不成立——論文寫「a sub-division with c>2 is an LPU if the region has its own long-range tracts」 |
神經束的節點:正文寫 LPU、補充材料寫 neuropil
步驟七要用「有沒有神經束」來驗證 LPU。那神經束本身是怎麼定出來的?論文的正文與補充材料給了不同的答案。
| 出處 | 原文 | 節點是 |
|---|---|---|
| 正文 | we clustered neurons based on whether they follow a similar trajectory path linking specific LPUs | LPU |
| 補充材料 〈Searching Neural Tracts〉 ← 本專題照這一列實作 | For a selected neuron linking two neuropils, an average position of all terminals within each of the two regions was first determined…paths within the two selected neuropils were removed | neuropil |
差別很要緊。照正文那句,要找神經束得先有 LPU,而驗證 LPU 又要先有神經束——那是個循環。但照補充材料的演算法,神經束是在 neuropil 之間找的,根本用不到 LPU,循環就不存在。
兩處哪一個算數,論文沒有說。實作時建議照補充材料——那是唯一寫出可執行步驟的地方(兩端平均終點位置相距 < 30 個體素、總路徑長度相似度 > 60%),而且它讓步驟七跑得起來。
步驟以外合併:論文做了,但沒有寫成步驟
七個步驟從頭到尾只做一件事:在一個 neuropil 內部,找需不需要再細分。這也正是論文立的前提——LPU 的範圍「等於或小於」一個 neuropil。
但論文實際上還做了反方向的操作:把好幾個 neuropil 合起來,當成一個 LPU。
| 案例 | 論文怎麼處理 | 理由 |
|---|---|---|
| 蕈狀體 | 萼 + 葉 兩個 neuropil → 一個 LPU |
Kenyon cell 的樹突在萼、軸突在葉——它跨在兩部分之間,所以切開之後不是任一邊的 LN,合起來才是整個蕈狀體的 LN 族群。論文另外還加了一條理由:MB 裡的 KC 有相似的長程連結樣式 |
| 中央複合體 | 橢球體 + 兩個側三角 三個 neuropil → 一個 LPU |
同一個結構:論文明寫「Each EB LN gives dendrites at ipsilateral lateral triangle and axons surrounding the center ring」——EB 的 LN 本來就跨在側三角與中央環之間。原文的語氣是「可以視為(may be considered as)」 |
為什麼「都沒有 LN」反而變成合併的理由
論文那句話讀起來很奇怪:「the entire MB was one LPU because neither the calyx nor the MB lobe had its own populations of LNs」——兩邊都沒有 LN,怎麼會是合起來就有 LN 的理由?
蕈狀體正是這樣:Kenyon cell 的樹突在萼、軸突在葉。把萼和葉當成兩個區,KC 就是「跨區」的投射神經元,兩邊都不算它的 LN——所以兩邊都沒有 LN 族群。但把整個蕈狀體當成一區,這 2,500 顆 KC 就全部變成它的 LN 族群。
所以「切開後兩邊都沒有 LN」不是「這裡沒有 LN」,而是「切錯地方了」。該有的 LN 就跨在那條切線上。
這在我們的資料上量得出來。把蕈狀體的四塊合併成一個區域,重跑 LN 普查:
| 切成四塊時 | 合併成整個蕈狀體 | |
|---|---|---|
| 右側 | 萼 1、柄 0、垂直葉 0、水平葉 0 | 596 |
| 左側 | 四塊全是 0 | 619 |
從幾乎全是 0,一口氣變成上千顆。那些神經元一直都在,只是在細的分區下不符合「LN」的定義。
把蕈狀體與中央複合體這三組都併回去,全腦的 LN 候選從 6,922 增加到 8,143 顆(
scripts/merge_check.py)。
條件一(要有自己的 LN 族群):切開後兩邊都沒有 → 合起來才有。
條件二(要有自己的長程神經束):「KCs in an MB share similar long-range connectivity patterns」——蕈狀體裡的 KC 對外連結的樣式相似,所以把它當一個單位看是合理的。
本節開頭那張合併案例表的「理由」欄把兩條都列了,但真正撐起「合併」這個動作的是第一條。
這兩個合併在圖 5A 那張正負號表上留下了痕跡:表裡同時有 Cal(−)、MB(−)與 Cal+MB(+),也同時有 Lat Tri(−)、EB(−)與 Lat Tri+EB(+)。那兩列合併項,就是這一步的存在證據。
後果很直接:照著七個步驟跑,你永遠跑不出蕈狀體與中央複合體那兩個 LPU。而這件事會決定最後的總數是不是 41。
收尾想重跑這條流程,會卡在哪
把整條流程走完之後,該講清楚的是:這七個步驟不足以讓另一個人重現論文的 41 個 LPU。缺口有十個,分成三類:三個沒給的參數、五處定義含糊,加上兩件論文做了卻沒寫成步驟的事。
下面三張表給這十個決定各編一個號(①–⑩),PART 3 每一條指令都會標明它寫死了哪幾個,PART 4 則記錄那些決定實跑起來會怎樣。(注意:這裡的 ①–⑩ 是「決定」的編號,跟 STEP 3 那兩條規則 ①②沒有關係。)
三個沒有給的參數
| 編號 | 在哪一步 | 缺什麼 | 影響 |
|---|---|---|---|
| ② | STEP 3 | UPGMA 樹的切割高度 | 直接決定找到幾個候選 LPU。同一個右觸角葉可以是 1 個,也可以是 15 個 |
| ⑥ | STEP 5 | 等值面的門檻 | 決定候選 LPU 的體積,連帶影響 c 值。同一批神經元只換這個門檻,區域從腦區的 373.7% 縮到 37.4%、c 值從 248.9 掉到 1.22(205 倍),中途跨過 c > 2——見 STEP 5 那張掃描表 |
| ④ | STEP 4 | 起始種子怎麼挑 | 論文的條件「纖維完全侷限在該候選 LPU 內」在右觸角葉上按字面挑不出任何一顆(最接近的只有 23.6% 落在裡面),在 AVLP_R 上卻挑得到(最高的一顆是 99.1%,scripts/seed_check.py)——論文沒有寫「一顆合格的都挑不到時該怎麼辦」。放寬成「有一部分在裡面」則沒給比例。而且它明寫是目視決定的——換一顆種子,招募結果可能不同 |
五個定義上的含糊
| 編號 | 在哪一步 | 含糊在哪 | 影響 |
|---|---|---|---|
| ① | STEP 1 | v(r) 是數纖維條數,還是數重疊的神經元數 | 補充材料與圖 S5D 的說法不同。從二值化影像只做得到後者 |
| ⑩ | STEP 4 | 招募時比對的那一團,是滾雪球的種子,還是分群本身 | 補充材料寫「收進來的併成新的種子」(靶愈滾愈大),圖 S5D(e) 的圖說寫 recruited based on the coverage of the two clusters(靶就是分群,固定不動)。兩處不一致,而選哪一種決定這一步跑不跑得動——滾雪球那一種在三個腦區、388 組參數下沒有一組收到中間結果 |
| ⑤ | STEP 4 | 膨脹的細節:50% 的分母、撐大多少 | 論文寫 all voxel units enlarged(兩邊都撐大),但沒說 50% of its volume 的分母是 target 撐大前還是撐大後——差別大到其中一種讀法會算出超過 1 的比例;「4 倍」是每方向還是體積也沒說(差 16 倍),而格點上撐大 1 格體積就已經是 6.2 倍 |
| ③ | STEP 3 | UPGMA 平手時挑哪一對 | 體素在規則格點上,距離大量重複(490 萬對只有 557 種值)。演算法沒有規定,實作按輸入順序挑;打亂順序,同一個高度的答案可差 8 個 |
| ⑦ | STEP 7 | 神經束的節點是 LPU 還是 neuropil | 正文寫 LPU(會造成循環),補充材料的演算法寫 neuropil(不會)。兩處不一致,論文沒有裁決 |
還有兩件不在七個步驟裡的
| 編號 | 在哪裡 | 缺什麼 | 影響 |
|---|---|---|---|
| ⑧ | STEP 0 | 誰算 LN,論文是目視判定的 | 原文是 visually inspected and delineated。想自動化就得自己挑一條規則(我們用「至少 80% 的分枝待在同一區」),而規則一換,普查結果就換 |
| ⑨ | 步驟以外 | 合併 | 照七個步驟跑,永遠跑不出蕈狀體與中央複合體那兩個 LPU |
八個缺口加上這兩件,總共十件事需要重跑的人自己決定。