1四個零件
先說本頁最後的答案(用到的詞第 5 節都會講:「永遠停牌」是每手都不再拿牌的固定打法;「種子」是亂數的起點,換一個種子等於換一副洗法不同的牌重打;「逐格表」是模型對每一種牌面各選什麼動作的整張表,只看每手的第一個決定;「勝率」在本課指平均每手的淨輸贏幾注,通常是負數,愈接近 0 愈好,不是贏的場數比例):這個模型打完整場訓練之後,成績比沒學過好很多,平均略好於永遠停牌,但離最佳打法還很遠。這是 PART 4 加跑的二十個種子的平均;單一種子之間差得不小,最好的那個種子比永遠停牌好很多,但它是二十個裡挑出的最高值,單一種子的勝率本身也帶著不小的誤差,有一部分可能是運氣(第 5 節)。逐格怎麼打,每個種子都以停牌為主,但要牌的格數從個位數到一百多格都有,每個種子學到的表差很多(數字在第 5 節)。成績變好,主要是表從幾乎全要牌移到以停牌為主;和最佳打法表逐格比,除了「補到 21 點別再要牌」那兩列,其餘的格子學完和沒學過分不出差別(第 5 節)。下面先講它由哪些零件組成。
連結體(connectome)是一張清單:一顆腦裡每一顆神經元、它連到哪些神經元、每一條連結有幾個突觸(synapse:兩顆神經元之間傳訊號的接點;一條連結的突觸愈多,通常影響愈大)。它本身是靜態的,不會動。fly-blackjack(本課要重現的那個 GitHub 專案的名字,作者是 WilliamJones)要讓它「學 21 點」,模型由四個零件組成:① 是連結體本身,其餘三個是人接上去的:
| 零件 | 它回答的問題 | 來自資料,還是人為設定 |
|---|---|---|
| ① 連結體 | 誰連到誰、連得多強 | 資料(電子顯微鏡重建:把整顆腦切成極薄的切片逐張拍照,再由電腦與人工沿著每顆神經元在相鄰切片間描出來、數出接點,得到「誰連到誰、幾個突觸」的清單) |
| ② 神經元方程式 | 一顆神經元收到輸入之後怎麼反應 | 人為設定(含一條:全部連結都只會提高下游的反應、沒有壓低的;下游=一條連結指向的那一顆,第 3 節末講) |
| ③ 輸入編碼 | 牌面(自己的手牌配莊家翻開的那張牌)怎麼變成神經元的輸入 | 人為設定 |
| ④ 讀出規則 | 哪些神經元的活動、怎麼換成「要牌」「停牌」或「加倍」(21 點裡玩家能做的三個動作,第 3 節圖 2 前的「先懂這手牌」解釋) | 人為設定 |
另外還有一條學習規則:它會調整零件 ① 裡某一層連結的強弱。層:從一群神經元到一群神經元(可以是另一群,也可以是同一群,例如第 2 節的輸出神經元 MBON 彼此之間)同一方向的全部連結算一層,第 2 節列出留下的四層。它不動量到的突觸數,動的是乘在連結上的一個係數,這個係數第 3 節起叫「增益」。它不算第五個零件:零件是模型的結構,它是改變零件 ① 的程序;第 4 節講,第 6 節總表把它另列一列。
這一頁先講資料(第 2 節)、神經元方程式(第 3 節)、學習規則(第 4 節),再講 21 點實驗本身:牌面怎麼變成氣味、怎麼選動作、怎麼學(第 5 節),整理成一張總表(第 6 節)。作者的 repo 裡還有三個本課不重現的實驗,最後一節(第 7 節)只簡介,讓你知道它們和 21 點是什麼關係。repo 是 GitHub 上一個專案的程式碼倉庫;README 是它首頁的說明文件,後面會一直用這兩個詞。
2資料:從 MaleCNS 切出蕈狀體
fly-blackjack 用的連結體是 MaleCNS v1.0:一隻雄果蠅的腦加腹神經索(從腦往身體延伸的那段神經組織)的連結體。它不模擬整顆腦,而是切出蕈狀體(mushroom body)——果蠅形成氣味記憶的腦區——裡的四種神經元:
| 神經元 | 顆數 | 角色 |
|---|---|---|
| 投射神經元(PN) | 682 | 把觸角葉(嗅覺訊號進腦的第一站)的氣味訊號送進蕈狀體。在 21 點裡,牌面就是從這裡灌進去的(第 5 節) |
| Kenyon 細胞(KC) | 1,200(從 3,811 顆裡抽出,抽法見表下) | 每種氣味只活化少數幾顆,形成這種氣味的「代碼」 |
| 蕈狀體輸出神經元(MBON) | 97 | 把蕈狀體的判斷送出去。真果蠅裡,這個判斷是對一種氣味要趨近還是迴避;在 21 點裡,這手牌配上每個可選的動作各判斷一次(第一個決定三個動作,之後只剩要牌、停牌兩個),好惡值愈高,愈被當成該做的動作(第 5 節) |
| 多巴胺神經元(DAN,PAM 與 PPL1 兩群) | 332(PAM 316、PPL1 16) | 送「這一手贏了或輸了」的訊號。多巴胺在這個模型裡不是「快樂」,只是一種信差分子,獎賞和懲罰都靠它送:PAM 那群放出來就是獎賞、PPL1 那群放出來就是懲罰 |
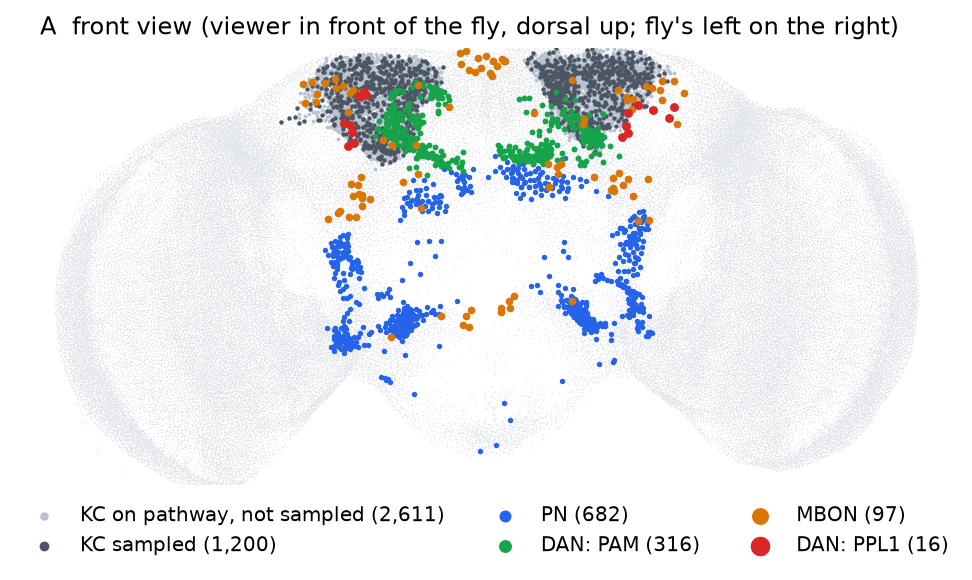
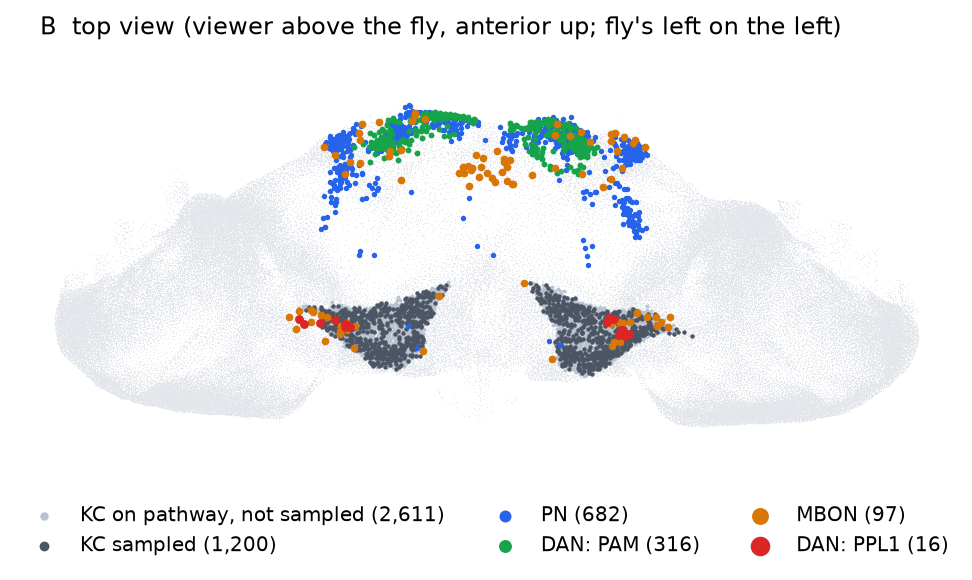
圖 1 本課用到的四群神經元,細胞體在腦裡的位置。細胞體是神經元的本體,纖維從這裡長出去伸進腦內,和別的神經元接線都在纖維上。底色的極淡灰點是 MaleCNS 腦部全部 123,322 顆有座標的細胞體:果蠅的細胞體都排在腦的表面,點一多,腦的輪廓就自己浮出來(腹神經索的細胞體沒畫)。這張圖只畫細胞體,不畫神經元的形狀:每顆神經元的纖維從細胞體伸進腦的深處,接線都發生在那裡;本課手上的資料只有細胞體座標與突觸數,沒有纖維的形狀。方位詞:背側是頭頂那一面(上)、腹側是下面,前側是臉那一面、後側是後腦那一面。看得出來的事:KC 擠在背側後方(上方偏後)兩團,深灰是作者抽中的 1,200 顆、中灰是路徑上沒抽中的 2,611 顆(3,811 − 1,200;抽法見下一段;中灰比底色深,但沒抽中的 KC 和抽中的擠在同一團裡,分不開是正常的);PN 圍在腹側前方的觸角葉旁邊;PAM 在 KC 團前下方排成一條帶;PPL1 只有 16 個紅點,靠在 KC 團外側;MBON 散得最開。MBON 散開,不代表它們不在蕈狀體上。蕈狀體是腦內部的一塊纖維區,這張圖沒有畫出來:KC 的纖維從背側後方的細胞體往下,先在萼部(就在 KC 團下方)收 PN 的輸入,再一路往前伸到前方的葉部,在那裡把訊號交給 MBON;所以 KC 那兩團也只是細胞體,不等於蕈狀體本身。每種 MBON 的樹突都落在蕈狀體的某一格,資料表直接寫在名字的括號裡,例如 MBON01(γ5β′2a) 在葉部的 γ5 與 β′2a、MBON22(calyx) 在萼部;細胞體則排在腦表面,用一條纖維連到那一格,位置不必在蕈狀體上。MBON 的細胞體依前後分成兩群,中間空了一大段(前後座標 18,888 到 28,935 之間沒有任何一顆):前方 60 顆,例如 MBON01、06、07、11,和 PAM 那條帶相鄰(PAM 的纖維也伸進葉部);後方 36 顆靠在 KC 團旁邊,包括樹突在萼部的 MBON22;另 1 顆沒有細胞體座標。模型只用突觸數、不用位置,所以這張圖的分布不影響任何結果。圖例的數字是細胞數,和上表相同;其中有幾顆沒有細胞體座標(PN 6 顆、抽中的 KC 2 顆、沒抽中的 KC 10 顆、MBON 1 顆),圖上畫不出來。資料裡另有 253 顆 KC 不在路徑上(只接到 PN 或只連到 MBON,作者一開始就不收),沒上色,留在底色裡。
(本頁出處的寫法:flybrain/ 開頭的是作者 repo 裡的程式;scripts/ 與 out/ 開頭的是本課課程倉庫另寫的程式與它算出的結果;「下載包」是 PART 2 讓你下載的本課程式資料夾。)由 scripts/make_soma_fig.py 從 MaleCNS 的神經元表(細胞體座標)畫出。資料表裡每顆細胞體只有 x、y、z 三個數,沒標哪邊是前、哪邊是上,所以哪個軸是哪個方向要用幾群位置已知的神經元算出來(這幾群在腦裡的前後上下,解剖文獻早就知道),不能用看的:左右用資料表的 somaSide 欄、背腹用 KC 對 GNG(腹側的腦區)、前後用 PN 對 KC 與 T4/T5(視葉,眼睛後面處理視覺的腦區,最後方的細胞)各算平均座標;數字在 out/blackjack/soma_fig.json。MBON 的前後分群與名字括號裡的分區,由 scripts/mbon_soma_probe.py 讀同一張神經元表算出,在 out/blackjack/mbon_soma.json。
KC 怎麼抽:作者先只留「同時接到 PN、又連到 MBON」的 KC(路徑上的 KC,共 3,811 顆),再依每顆「收到 PN 的突觸數加送到 MBON 的突觸數」排名、等距抽 1,200 顆(排好名後每隔約三顆取一顆),說是為了省計算;PART 4 的 X3 檢查(X1 到 X4 是 PART 4 的四項檢查的代號)換成全部 3,811 顆再打一次 21 點,看結果變不變。
PAM 316 顆對 PPL1 16 顆,差二十倍,是果蠅解剖本身的事:PPL1 分 8 型,每一型左右腦各只有一顆;PAM 分 15 型,每一型是一小群長得幾乎一樣的細胞(型:資料集替長得一樣、接線一樣的細胞取的同一個名字)。顆數差這麼多會不會讓懲罰訊號太弱,第 4 節末尾回答。
留下的四層連結。PN→KC 7,182 條、KC→MBON 18,183 條、DAN→MBON 3,123 條、MBON→MBON 1,606 條,每條的突觸數照連結體。
不收的連結。KC 之間的連結作者刻意不收,理由寫在他的程式註解裡,分兩句;本頁再補一個。第一,資料裡 KC 之間有六十幾萬條連結,幾乎全是只有一個突觸的,作者把它們當成不可靠的連結。第二,真實果蠅裡讓 KC 保持稀疏(稀疏:同一時間只有少數 KC 在活動)的是另一顆叫 APL 的抑制神經元,不是 KC 之間的連結;而 APL 的作用模型裡已經用一條規則代替了(第 3 節的「只留最高的 6%」),所以留下 KC 之間的連結對稀疏沒有幫助。第三(本頁補的):如果收進來,活化的 KC(亮的 KC;第 3 節起都用「亮」)會沿這些連結再去推動其他 KC、改變亮哪幾顆,但第 3 節的式子裡亮幾顆由規則定死、亮哪幾顆只看 PN 推得多高;要用這層連結,就得在式子裡多加一項「KC 推 KC」,作者沒有這樣做,這是作者的選擇,不是資料逼出來的。為什麼不把 APL 也切進來、而用規則代替,作者沒說。資料裡四群之間其他方向也有連結(KC→DAN、DAN→KC、MBON→DAN、MBON→KC、PN→MBON 都有),作者一樣沒收;其中接進 DAN 的那兩種用不到,因為模型裡 DAN 的活動不是算出來的、是輸贏時直接給的(第 3、4 節),其餘幾種不收的理由作者沒寫。
README 與檔案的數字對不上。上面四個連結數是切出來的檔案裡數出來的,與作者另外存進 repo 的一份清點檔(切完程式自動寫下細胞數與連結數)相同;但作者 README 正文寫的 PN→KC 22,586 條、KC→MBON 61,210 條和檔案裡的 7,182、18,183 對不上。README 的兩個數是資料裡全部 4,064 顆 KC、還沒篩選也沒取樣時的連結數(本課逐位核對過),檔案裡的是篩完、取完 1,200 顆之後的。模型實際讀進去的是檔案,本頁與後面各 PART 用的都是檔案裡的數字;怎麼查出來的,PART 3 第 3 節會講。
細胞數與連結數出自 out/blackjack/logs/bj2_extract_run1.log 與作者的紀錄檔 out/upstream/blackjack_mb_manifest_committed.json。
3神經元方程式:活動量,不放電
真實神經元靠放電(spike:細胞膜內外的電壓差叫膜電位,放電就是它瞬間上衝一次)傳訊號。fly-blackjack 不模擬放電:每顆神經元只有一個沒有單位的活動量,作者在 README 明寫這些數字「不是放電率,也不是膜電位」。蕈狀體的算法只有三條式子。式子裡的「權重」是一條連結的突觸數除以總數(每一層各自除,細節在式子後的小字);「增益」是學習會改的一個乘數,起始 1,第 4 節講;PN 的活動是輸入給的(每顆被選中的 PN 給一個 0.7 到 1 的固定數,有一組乘 1.3,其餘 0;怎麼分組、怎麼定在第 5 節):
MBON 活動 = ΣKC(KC 活動 × KC→MBON 權重 × 增益)+ 0.25 × Σ其他 MBON(MBON 活動 × MBON→MBON 權重);0.25 是作者定的常數(人設,為什麼是 0.25 作者沒說明)
好惡值(valence) = ΣMBON(MBON 活動 × 標記),標記是 +1(趨近型)或 −1(迴避型);哪顆是 +1、哪顆是 −1 怎麼定,第 4 節。這條式子算在零件 ②,但式子裡的 ±1 標記歸零件 ④,因為它決定讀出往哪個方向走
Σ 讀作「加總」:ΣKC(…)就是把每顆 KC 的那一項算出來再全部加起來,和第一條的「總和」是同一件事。權重一律是突觸數除以總數,而且每一層各自除:KC→MBON 的權重是那條連結的突觸數除以該 MBON 從全部 KC 收到的突觸總數,MBON→MBON 那層另外除、DAN→MBON 那層也另外除,所以每顆神經元在每一層的輸入權重各自加起來是 1(精確的式子見下方附註「連結權重的精確定義」)。增益是第 4 節會變的那個數,起始是 1。MBON 那一式分兩步算:先算 KC 那一項得到每顆 MBON 的初步活動,再把這些初步活動經 MBON→MBON 接線加權加回來,只加一次,不反覆。
多巴胺神經元(DAN)不在這三條式子裡:模型不算它們的活動,一手牌輸或贏時直接把懲罰群或獎賞群整群當成在放多巴胺。第 2 節的 DAN→MBON 那層接線只在第 4 節的學習規則裡用到,決定多巴胺送得到哪些 MBON。
附註:連結權重的精確定義(已對作者程式)
原料:突觸數。nij 是上游神經元 i 到下游神經元 j 的突觸個數,取自 MaleCNS 的突觸數矩陣(作者 fetch.py 下載的 mcns_syncount_all_neuron.npz)。四層都是正整數,最少 1 個:PN→KC 最多 88 個、KC→MBON 最多 152 個、DAN→MBON 最多 781 個、MBON→MBON 最多 583 個。沒有正負號,也沒有用傳導物質。
定義:每一層各自除以下游收到的總數。同一層(例如 KC→MBON)裡,
wij = nij ÷ Σi′ ni′j
分母的 Σi′ 只加這一層、這個模型裡的上游細胞:KC→MBON 那層只加切出來的 1,200 顆 KC,不是資料裡全部的 KC。作者 model.py 的 _normalise() 就是把矩陣每一欄(一顆下游神經元)除以該欄總和;四層的每一欄都至少收到 1 個突觸,所以沒有分母是 0 的情形。結果每顆下游神經元在每一層的權重加起來剛好是 1(本課重算過,四層每一欄的誤差都小於 10−14)。
正規化的後果。權重只看「這條連結占下游輸入的幾成」,不看絕對數量。KC→MBON 那層,收到 KC 突觸最少的 MBON 只有 9 個,一個突觸的權重是 1/9;最多的 MBON11 有 7,413 個(來自 647 顆 KC),連到它最強的那顆 KC 有 63 個突觸,權重也只有 63 ÷ 7,413 ≈ 0.0085。兩顆 MBON 收到的 KC 輸入總權重都是 1。
權重在三條式子裡的位置。a 是活動量,g 是增益(第 4 節):
KC 的輸入:dk = Σp wPN→KCpk · ap
MBON 初步活動:mj = Σk wKC→MBONkj · gkj · ak
MBON 活動:aj = mj + 0.25 · Σj′ wMBON→MBONj′j · mj′
送到 MBON 的多巴胺:δj = Σd wDAN→MBONdj · Dd(D 是懲罰群或獎賞群整群給的強度)
增益 gkj 乘在正規化之後,乘完不再重新除:一開始 g 全是 1,學習只會把它往下削,而且限制在 0 到 1 之間,所以學過之後一顆 MBON 的 KC 輸入權重 × 增益加起來會小於 1。MBON→MBON 那層有一條是 MBON09 接回自己(1 個突觸,占它 387 個輸入的 0.0026),程式沒有排除,所以上面 Σj′ 也含 j 自己。
和 ViZDoom 那一課不同。fly_doom 用的是 突觸數 × 正負號 × 0.275 mV,不除以任何總數,正負號看上游的傳導物質;這裡全部是正的比例,好惡的方向改由 MBON 的 ±1 標記決定(第 4 節)。
程式:作者 flybrain/mb/model.py 的 _dense、_normalise、present(PART 6);數字出自 out/weight_def.json(scripts/weight_def_probe.py 直接讀 data/mb_circuit.npz 重算,並確認和作者模型裡的矩陣一致)。
APL 是什麼、「只留最高的 6%」和它差在哪
APL 是什麼。APL(anterior paired lateral neuron)是蕈狀體裡一顆很大的抑制神經元,左右腦各一顆,放的傳導物質是 GABA(讓下游更安靜的那一種)。它的纖維鋪滿整個蕈狀體:KC 活動時會推動 APL,APL 再把抑制送回全部 KC;KC 整體愈活躍,APL 就愈強、壓得愈多。這種「輸出回頭壓自己」的接法叫負回饋。MaleCNS 裡量得到這兩顆:資料裡 4,064 顆 KC 有 4,063 顆送突觸給 APL(共 210,352 個突觸),APL 也送突觸回 4,063 顆 KC(共 196,200 個)。作者切蕈狀體時沒有收它。
為什麼要稀疏。真實果蠅一種氣味通常只讓一小部分 KC 活化(約 5% 到 10%:Honegger 等人 2011 用鈣影像量到平均約 5%,沒有一種氣味超過 10%)。代碼稀疏,兩種氣味的代碼重疊就少,學習時削弱某一種氣味的連結,比較不會連帶改到另一種。實驗上把 APL 關掉,KC 的反應變多、代碼重疊變大,果蠅就比較分不出兩種相似的氣味;兩種差很多的氣味則照樣分得出來(Lin 等人,2014,Nature Neuroscience)。也就是說,稀疏的代碼主要是在幫忙分開「很像」的東西。放到 21 點:「硬 20 配要牌」和「硬 20 配停牌」的代碼要分得開,學到的教訓才不會混在一起;圖 2 第 6 步裡,兩者亮的 72 顆 KC 只有 12 顆相同。
規則和真實 APL 差在哪。作者的規則一般叫 k-winners-take-all(只讓前 k 名活動),在 model.py 裡是常數 KC_SPARSITY = 0.06(PART 6 第 6 節逐行講)。它抓住了「只有少數 KC 亮」這個結果,做法卻不一樣:
- 亮幾顆:規則每次固定 72 顆;真實 APL 的抑制跟著 KC 總活動變,輸入強弱不同,亮的顆數也不同。
- 怎麼壓:規則直接把第 73 名以後歸 0;真實 APL 是把每顆 KC 都往下壓,壓不過門檻的才不亮。
- 活動量大小:規則把留下的 72 顆除以其中最大值,最亮的一律是 1;真實 KC 的反應不會這樣重新縮放。
- 時間:規則一步算完;真實的負回饋要 KC 與 APL 來回作用一段時間才穩定。
作者為什麼不收 APL。作者沒說。本課的推測(沒有查證):模型裡的連結全部當成推高、也沒有時間步,要放進一顆會回頭抑制的 APL,得加上負的連結和「反覆算到穩定」的迴圈;一條固定比例的規則簡單得多,也一樣做得出稀疏的代碼(兩種做法學起來差多少,本課沒有比過)。代價是 6% 變成一個人選的數字,作者也沒說明為什麼是 6%。
APL 的顆數與突觸數由 scripts/apl_counts.py 從 MaleCNS 的連結表數出,存在 out/blackjack/apl_counts.json;作者註解原文是 “k-winners-take-all stands in for APL inhibition”(model.py 的 kenyon_from_drive)。文獻:Lin, Bygrave, de Calignon, Lee & Miesenböck (2014) Sparse, decorrelated odor coding in the mushroom body enhances learned odor discrimination. Nature Neuroscience 17: 559–568(全文;APL 左右各一顆、GABA、KC 與 APL 互為負回饋、關掉 APL 的三個結果都出自這篇);Honegger, Campbell & Turner (2011) Cellular-resolution population imaging reveals robust sparse coding in the Drosophila mushroom body. Journal of Neuroscience 31: 11772–11785(全文;約 5%、不超過 10%)。
先懂這手牌(沒玩過 21 點的人看這段;第 5 節有作者簡化的幾條)。莊家:發牌、和你對賭的那一方(賭場);一手 21 點只有你和莊家兩方比。一手牌的時間線:押一注(注:賭注的單位)→ 你拿兩張、莊家拿兩張但只翻開一張給你看(明牌)→ 你做決定(要牌、停牌或加倍,下面解釋),可以重複好幾次 → 你停了之後莊家補牌 → 比大小結算。點數:2 到 10 照面值,J、Q、K 算 10,A 算 1 或 11(哪個對你有利算哪個);手上有 A 算成 11 而沒爆的叫軟手,其餘叫硬手;超過 21 叫爆牌、直接輸。三個動作:要牌 = 再抽一張,沒爆就再決定一次;停牌 = 不抽了;加倍 = 只在第一個決定(手上還只有發的兩張)能選,再押一注、只再發你一張就強制停牌,輸贏都算兩注。莊家補牌:翻開蓋牌,不到 17 點一定抽、到了就停;莊家爆了而你沒爆就是你贏。結算:贏了淨賺一注、輸了賠一注、平手原注拿回。
- 第 1 步 牌面變成 PN 的活動。這手的局面(本頁用詞:牌面=自己手上的點數配莊家明牌;局面=牌面再加上軟硬、是不是前兩張;氣味=局面配一個候選動作)。硬 20:你手上 10+10,沒有 A 算成 11;硬 20 再抽除了 A 以外都爆,軟手再抽一張不會爆(A 可以改算 1)。莊家 8:翻開的那張是 8,你做決定時只看得到它。前兩張:你還沒抽過牌,所以加倍也能選,三個動作都開著。編碼。這個局面拆成五項資訊:硬 20 是兩項(點數 20、硬手),加上明牌 8、前兩張、候選動作「要牌」,各選中一組 PN(哪一組對哪個值,是作者事先用固定亂數抽定的,人設,和這些 PN 在真果蠅裡聞什麼無關;第 5 節講):點數 26 顆、明牌 22 顆、動作 36 顆、軟硬 12 顆、前兩張 8 顆,五組共 104 顆,其中 8 顆被兩項資訊同時選中、只算一次,實際亮 96 顆,其餘 586 顆是 0。每顆被選中的 PN 各有一個 0.7 到 1 的固定數當活動量,動作那組乘 1.3,被同時選中的把兩邊相加;整欄超過 1 的有 32 顆,多數是動作那組。圖上亮度照活動量。
- 第 2 步 每顆 KC 收到多少。每顆 KC 把「收到的每顆 PN 的活動 × 那條連結的權重」加總;權重是突觸數除以該 KC 收到的 PN 突觸總數。1,200 顆裡 542 顆收到非零的量(接到亮的 PN 才有),最高 1.069。圖上 KC 欄變成深淺不一。
- 第 3 步 只留最高的 6%。1,200 顆只留最高的 72 顆,其餘歸 0;留下的 72 顆除以其中最大值,變成 0 到 1。這 72 顆就是「硬 20 對 8 配要牌」這種氣味的代碼。這一步是作者用規則代替真果蠅的 APL,是人為設定。
- 第 4 步 亮的 KC 推動 MBON。每顆 MBON 把「每顆亮的 KC 的活動 × KC→MBON 權重 × 增益」加總(這是訓練的第一手,增益全是 1,什麼都還沒學),再加上 0.25 × 其他 MBON 推過來的量。圖上 97 顆 MBON 各一條長條,長度是活動量,最高 0.181;每顆亮的 KC 只畫它推得最用力的那一條線。
- 第 5 步 加總成好惡值。每顆 MBON 乘它的標記再全部加起來。圖上 MBON 依標記排成兩堆:上面 56 顆 +1(趨近型)、下面 41 顆 −1(迴避型)。加分堆 1.618、扣分堆 1.375,相減得到配「要牌」的好惡值 0.243。
- 第 6 步 三個動作各算一次,選最高。同一手牌配停牌、配加倍再各走一遍步驟 1 到 5:PN 只換「動作」那組。三個好惡值:要牌 0.2432、停牌 0.1681、加倍 0.0185,選最高的要牌。用上面的按鈕切換三個動作,看 PN、KC、MBON 怎麼跟著換;細節在六步下面的「第 6 步的細節」。
第 6 步的細節
PN 怎麼換:不換的四組共 68 顆,其中被兩組同時選中的只算一次,是 65 顆,加上要牌與停牌的動作組碰巧撞到的 1 顆,所以要牌與停牌亮的 PN 有 66 顆相同。
KC 為什麼幾乎全換(72 顆裡只有 12 顆相同):動作那組乘了 1.3,是推得最用力的一組,換動作等於換掉最強的 36 顆輸入,每顆 KC 收到的總量都跟著動,前 72 名的名單就大洗牌;作者在 Situation(作者程式裡把牌面變成 PN 輸入的那一段)的註解裡寫,動作給最寬的代碼,「因為選擇正是要學的東西」;三種氣味只差在動作、代碼卻差很多,就是這個設計的結果。
這一手的後續:模型有時會不看好惡值、隨機選一個動作(第 5 節叫探索),實跑裡這個決定沒有亂選,是照好惡值選的。接著抽到 6,爆牌,輸一注,懲罰多巴胺送出去(第 4 節)。基本策略(賭場數學算出來的公開最佳打法表,第 5 節)在 20 點該停牌;沒學過的果蠅在 20 點還要牌:它幾乎每格都選要牌,為什麼偏要牌,見第 5 節「未訓練的對照值」那段。
圖 2 三條式子走一遍:第 1 手的第一個決定(硬 20 對莊家 8、前兩張)。按「上一步」「下一步」一步一步走,每一步的說明在圖下。例子出自一次正常的訓練(有學習、有探索,第 5 節叫它完整模型)、打牌種子 0(種子:給亂數產生器的起始數字,第 5 節講)的第 1 手;因為是整個訓練的第一個決定、增益還全是 1,不必重放整段訓練,直接用作者的模型就能重算每一欄,三個好惡值與 PART 5 錄下的實跑相同。PN、KC、MBON 全部畫出,不是示意。沒有 JavaScript 時看到的是第 5 步配「要牌」的靜態圖。數字由 scripts/anim_data.py 用作者的 flybrain/mb/model.py 算出,存在 out/blackjack/anim_data.json;圖由 scripts/make_anim.py 產生。
簡報要演示的話:圖 2 單獨頁只有這張圖,版面配合 16:9 投影片,功能和上面一樣,可以用 PowerPoint 的網頁增益集嵌進投影片(要能上網),也可以下載後用瀏覽器直接開(單一檔案,不用網路);鍵盤 ← → 換步驟、1 2 3 換動作、D 顯示這一步的說明。不想用瀏覽器的話,投影片用圖(約 4 MB)有九個畫面(開始、第 1 到 5 步、第 6 步的三個動作),每個都有 PNG 與 SVG,一張投影片放一個畫面即可。
算法出自 fly-blackjack 的 flybrain/mb/model.py;72 顆是 1,200 的 6% 四捨五入,比例 0.06 與 MBON→MBON 的 0.25 都是 model.py 檔頭的常數。
4學習規則:多巴胺只會削弱
學習規則只有一條。某顆 KC 正在活化、而且它連到的 MBON 同一時刻收到多巴胺,這條 KC→MBON 連結就變弱。只會變弱,不會變強:下面的「回復」最多回到起始的 1,不會超過;「不會變強」指不會比起始強。變的不是連結體量到的突觸數,而是乘在每條 KC→MBON 連結上的一個增益:起始是 1,收到「KC 活化+多巴胺」就往下掉、最低到 0;另外每「呈現」一次都往 1 回復一點點,所以沒再被削弱的連結會慢慢復原。整個模型裡只有 KC→MBON 這一層會變,PN→KC、DAN→MBON、MBON→MBON 全部固定。
生物依據與簡化。「KC 活化時多巴胺來了,KC→MBON 就變弱」有直接的實驗證據:在果蠅腦裡把 KC 的活動和多巴胺配在一起,這個突觸的傳遞會長期變弱(Hige 等人,2015,Neuron)。但「只會變弱」是作者的簡化:真實果蠅裡,多巴胺比 KC 活化先到時,同一個突觸反而會變強(Handler 等人,2019,Cell);模型只取了證據最直接、最主要的削弱這一種。真實果蠅在遺忘時,被削弱的反應也會回到原本的大小,不只是時間久了自然回復,學完後再被電擊或接著改學也會讓它回復得更快(Cervantes-Sandoval 等人,2020,Frontiers in Cellular Neuroscience);這和模型的「回復」方向相同,只是模型只有隨每次呈現慢慢回復這一種。
什麼叫呈現。把一個輸入送進蕈狀體走一遍 PN → KC → MBON,而且這一遍允許增益改變,叫一次呈現。21 點裡,呈現只發生在一手牌結束之後:這手牌做過幾個決定,就把每個決定當時的局面配上當時選的動作各送進去一次(第 5 節「學習」那段)。選動作時替每個能選的動作各算一次好惡值,走的是同一條路,但增益不准變,所以不算呈現。
增益 ← 增益 + 回復速度 × (1 − 增益)
「這顆 MBON 收到的多巴胺」是兩個數的乘積。第一個是懲罰或獎賞的強度(第 5 節:輸贏 1 注是 0.5)。第二個是比例:分子是這顆 MBON 從被觸發的那群多巴胺神經元(給了懲罰或獎賞訊號的那群)收到的突觸數,分母是它收到的全部多巴胺突觸數;這個比例由 DAN→MBON 的接線決定。「←」讀作「更新為」。多巴胺神經元沒連到的 MBON,這一項是 0,它的輸入連結就不會變。
每次呈現,上面兩行各做什麼。第二行(回復)每次呈現都做。第一行(削弱)要兩個條件同時成立才有作用:連結那一端的 KC 這次亮著,而且這顆 MBON 收到的多巴胺不是 0。例子:一手牌輸了,送懲罰多巴胺。哪些連結被削:從這次亮的 72 顆 KC,通往收到懲罰的 94 顆 MBON 的連結(PPL1 接到 97 顆裡的 94 顆,數字在本節末尾的補充)。各削多少:0.05 × 這顆 KC 的活動 × 0.5 × 這顆 MBON 來自 PPL1 的比例;趨近型的比例高、削得多,迴避型多半只接到一點懲罰群、只削一點點(數字在圖 3 的細節)。其餘的連結(沒亮的 KC 連出去的、通往沒收到懲罰的 3 顆 MBON 的)不削,只回復。平手那手不送多巴胺,作者也乾脆不呈現,所以 21 點裡沒有「呈現了卻沒有多巴胺」的情況;作者的氣味制約與覓食兩個實驗有(例如只給氣味、不電擊;另一個實驗 Dino 不用蕈狀體),那種呈現只回復。回復是往 1 拉:增益已經是 1 的連結,回復算了也不變。
多巴胺的兩個方向。每顆 MBON 帶一個固定標記:+1(趨近型)或 −1(迴避型)。下面這段是作者定這個標記的理由;21 點裡沒有電擊,這裡借果蠅實驗室最常用的例子(給氣味同時電擊,果蠅學會躲那種氣味;第 7 節的氣味制約)走一遍,因為它最短。先把接線理想化:假設 PPL1 只連到一部分 MBON(實際是 97 顆裡的 94 顆,下面兩段會講)。給氣味 A,A 的那幾顆 KC 活化。同時電擊,懲罰群多巴胺神經元(PPL1)放出多巴胺。PPL1 只連到一部分 MBON,所以只有「A 的 KC → 這部分 MBON」的連結變弱。下次再聞到 A,這部分 MBON 變安靜,其他 MBON 不變。果蠅要「學會怕 A」,A 的好惡值必須往負走。總和要下降,變安靜的那幾顆 MBON 原本就得是加分的那種,所以它們的標記必須是+1。結論:被懲罰多巴胺管的 MBON,就是趨近型。(這是把情況理想化來走,真實接線沒這麼乾淨,下面會說。)電擊不是按下「躲」的按鈕,而是把「去」的按鈕變鈍。獎賞群(PAM)反過來:它管的 MBON 是迴避型,獎賞把「躲」的按鈕變鈍,總和往正走。
作者的標記就是這樣定的。每顆 MBON 數它收到的多巴胺突觸,PPL1 多於 PAM 的標+1 趨近,PAM 多於 PPL1 的標 −1 迴避,得到 56 顆趨近、41 顆迴避。兩群一樣多的情況程式判給迴避型,實際上 97 顆沒有剛好一樣多的。97 顆每顆都至少接到一群:兩群都接 74 顆、只接 PPL1 20 顆、只接 PAM 3 顆(就是懲罰送不到的那 3 顆,標 −1),沒有一顆兩群都沒接,所以下面的「比例」不會碰到分母是 0。大多數 MBON 兩群都接(PPL1 接到 94 顆、PAM 接到 77 顆,本節末尾的補充),所以懲罰來時、獎賞來時,同一顆 MBON 都可能被削弱;但每顆收到的多巴胺大多來自其中一群:連結體原本的接線(PART 4 會打亂它)裡,一次懲罰送出的多巴胺有 97% 進了標 +1 的 MBON、只有 3% 進了標 −1 的;一次獎賞送出的有 93% 進了標 −1 的。所以送到「另一型」的那一小部分影響很小。這兩個百分比是 PART 4 第 3 節的 X2 算的:一次懲罰給每顆 MBON 的量是強度乘以它那個「來自 PPL1 的比例」(本節開頭),把 97 顆的量加總,看落在標 +1 那些的佔幾成。
為什麼主要接懲罰訊號的反而叫趨近型。看起來相反,是因為「誰管它」和「它做什麼」是兩件事:懲罰訊號的工作就是把趨近輸出關掉。真實接線沒有上一段的推導那麼乾淨:推導假設 PPL1 只連到一部分 MBON,實際上它接到 97 顆裡的 94 顆(數字在本節末尾的補充),幾乎每顆都連,差別在各顆收到的比例高低很多。所以作者不是用「有沒有連」、而是用「哪一群送來的突觸多」來定標記。97%/3% 是標記定完之後回頭算的,用來確認這樣定的標記和多巴胺實際的去向大致一致,不是定標記的依據。
這個標記哪一半是資料、哪一半是人設。上面的推導靠兩個前提:「多巴胺只削弱」和「電擊要讓好惡值下降」。這兩個前提出自果蠅學習研究的文獻(前一個是簡化過的,見本節開頭的「生物依據與簡化」),連結體裡量不到。所以:每顆 MBON 收到 PPL1 與 PAM 各多少突觸是連結體數出來的(資料);「PPL1 多的就是趨近型」這條對應規則是照文獻定的(人設)。PART 4 的第 4 項檢查(代號 X4) 會拿它去對實驗文獻。
補充:PPL1 只有 16 顆,懲罰訊號會不會太弱?不會,因為這個模型裡訊號的強度是輸贏時給的固定數,不是顆數加出來的。一手牌輸了就給一個固定數(第 5 節),每顆 MBON 收到的量是這個數乘以它那個「來自 PPL1 的比例」;突觸數會透過這個比例進來,但顆數(16 對 316)不會;而 PPL1 的突觸並不少:兩群都左右對稱(PAM 每側 158 顆、PPL1 每側 8 顆),PPL1 送到 MBON 的突觸共 11,070 個、平均每顆 692 個,PAM 共 28,546 個、平均每顆 90 個,PPL1 一顆抵 PAM 七、八顆,而且 97 顆 MBON 裡 PPL1 接到 94 顆、PAM 接到 77 顆。上面定標記時比的就是這兩群送來的突觸數,不是顆數。PAM 的總突觸數比 PPL1 多,也不會稀釋懲罰:「來自 PPL1 的比例」是每顆 MBON 各自算的,趨近型的多巴胺輸入主要來自 PPL1,所以一次懲罰時趨近型平均拿到 0.473(滿額 0.5)。
兩群的型數、每側顆數與送到 MBON 的突觸數由 scripts/dan_counts.py 從 MaleCNS 的神經元表與突觸矩陣數出,存在 out/blackjack/dan_counts.json。
兩個作者設定的數。學習率(一次「KC 活化+多巴胺」把增益砍掉多少)與回復速度(每呈現一次,增益往 1 回復多少)。21 點用的是學習率 0.05、回復速度 0.00005;作者在氣味制約實驗(第 7 節簡介)用的是 0.55 與 0.012,21 點每呈現一次回復的量只有制約那組的 240 分之一(0.012 ÷ 0.00005 = 240),削弱過的連結要很多次呈現才會回復。回復速度放慢的理由作者寫在程式註解裡:照制約那組設,一個局面的教訓在下次遇到同一個局面之前就被抹掉了,只剩「要牌常常輸」這種全面的教訓(不分牌面、對所有局面都成立的偏好;第 5 節「學習」那段有例子);為什麼全面的那個留得下來,作者沒有說明;本課的推測是:同一個動作在每一手都用同一組 PN,全面的教訓每一手都被重新削一次,回復再快也來不及抹掉,而一個特定牌面要隔很多手才遇到一次,中間的回復就把它抹掉了。學習率為什麼也從 0.55 降到 0.05,作者沒有說明。
整條規則走一遍。下面圖 3 接著圖 2 的那一手:硬 20 對 8 選了要牌、爆牌輸了,看一次呈現怎麼改動連結、好惡值怎麼跟著變。
- 第 1 步 一手結束,重新呈現。這手輸了。把這手唯一的決定「硬 20 對 8 配要牌」再送進蕈狀體一次:亮的還是圖 2 那 72 顆 KC,MBON 活動也和當時一樣。
- 第 2 步 送懲罰多巴胺。輸一注,懲罰強度 0.5。每顆 MBON 收到 0.5 × 它的「來自 PPL1 的比例」:94 顆收到、3 顆是 0;送出的多巴胺總量有 97% 落在上面的趨近型。
- 第 3 步 削弱。上面式子的第一行:亮的 KC 通往「收到多巴胺的 MBON」的連結,增益減掉 0.05 × KC 活動 × 多巴胺。這次動到 923 條,最多從 1 減到 0.975;其餘連結不動。下次再送同一個牌面,MBON 活動會變小,最右欄是少掉的量(放大 50 倍)。細節在下面。
- 第 4 步 回復。式子的第二行:所有連結都往 1 拉回一點。增益還是 1 的不變;剛被削弱的只拉回百萬分之一左右,這一次看不出來,要累積很多次呈現才有作用。
- 第 5 步 好惡值變了。被削弱的多半是趨近型(加分),所以要牌的好惡值從 0.2432 降到 0.2245。停牌、加倍也降了一點(0.1681 → 0.1636、0.0185 → 0.0138),因為它們的代碼和要牌共用十幾顆 KC。要牌仍最高,細節在下面。
圖 3 的細節
迴避型也會被削嗎:會,只是很少。懲罰時 97 顆 MBON 裡 94 顆收到多巴胺:趨近型 56 顆全收到,平均 0.473(滿額是 0.5);迴避型 41 顆裡 38 顆收到,但平均只有 0.019;中位數 0.006,約是趨近型中位數(0.492)的百分之一。所以「亮的 KC + 收到多巴胺」這個條件,兩型的連結幾乎都滿足,差別在削多少:趨近型的連結被削得多,迴避型的只削一點點。第 4 節「作者的標記就是這樣定的」那段的 97%/3%,講的就是這個量的比例,不是「只有一部分 MBON 收到」。
為什麼只動到 923 條:一顆 KC 只連到少數幾顆 MBON,72 顆亮的 KC 一共連出 982 條,其中 923 條通往收到多巴胺的 MBON。最多減 0.025 = 0.05 × KC 活動 1 × 多巴胺 0.5:出現在最亮的 KC(活動 1)通往只接 PPL1 的 MBON(多巴胺是滿的 0.5)的連結上。
為什麼好惡值往負走:好惡值=加分堆 − 扣分堆。學之前加分堆 1.618、扣分堆 1.375;學之後加分堆 1.598、扣分堆 1.373。懲罰多巴胺多半送到趨近型,所以加分堆少得多、扣分堆幾乎不動,相減就變小。
停牌、加倍為什麼也跟著降:削弱的是「亮的 KC → MBON」這些連結本身,不是「要牌」這個動作。停牌的 72 顆 KC 有 12 顆和要牌相同、加倍有 13 顆,這些 KC 的連結被削弱了,停牌、加倍算好惡值時也會用到。共用得少,所以降得少。
一次學習改變多少:要牌只降了 0.0187,仍比停牌高 0.0609。單看這一次,下次遇到同樣的局面還是會選要牌;要多輸幾次、把差距削掉,選擇才會換。而同一個局面配同一個動作很少重複出現(種子 0 的 30,000 手裡出現過 422 種局面:「前兩張」也是編碼的一項,同一個點數的第一個決定和之後的決定是兩種局面,第一個決定 260 種、之後的決定 162 種;這 260 種含硬 4、軟 12、不含硬 21、軟 21,和第 5 節拿來評分的那張 260 格表(每格一種點數、軟硬配明牌,一律當成第一個決定)不是同一組,只是數目碰巧相同;每個局面兩三個動作;本頁用詞對照:牌面=自己手上的點數配莊家明牌;局面=牌面再加上軟硬、是不是第一個決定;氣味=局面配一個候選動作;一致率表上的一「格」=一種(點數、軟硬、明牌),一律當成第一個決定來填),同一個局面配同一個動作可能要隔幾百手才遇到一次,而每個局面大致得各自輸好幾次才會換(削弱其實也會透過共用的 KC 擴散到別的局面,第 5 節),所以一次訓練要打很多手(作者設 30,000 手)。
回復的量:0.00005 × (1 − 0.975) = 0.00000125。制約實驗那組(0.012)回復得快 240 倍,所以 21 點刻意放慢,見本節「兩個作者設定的數」。
圖 3 學習規則走一遍:第 1 手輸了之後的一次呈現。按「上一步」「下一步」一步一步走,每一步的說明在圖下。例子接著圖 2:同一次訓練(打牌種子 0)的第 1 手,選了要牌、爆牌輸一注。這是整個訓練的第一次學習,學之前增益全是 1,所以每個數都能重算;學之前的三個好惡值與 PART 5 錄下的實跑相同;學之後的三個值實跑沒有錄(PART 5 只錄了前 6 手與最後 6 手的決定),是用作者這支學習程式直接算的。數字由 scripts/learn_anim_data.py 呼叫作者的 FlyPlayer.outcome(FlyPlayer 是作者程式裡負責選動作與學習的那一段,outcome 是一手結束後送回饋的那一步;flybrain/mb/blackjack.py)算出,存在 out/blackjack/learn_anim_data.json;圖由 scripts/make_learn_anim.py 產生。沒有 JavaScript 時看到的是第 3 步的靜態圖。
簡報要演示的話:圖 3 單獨頁只有這張圖,用法和圖 2 單獨頁相同(16:9 版面、可用 PowerPoint 網頁增益集嵌入,或下載後用瀏覽器直接開;鍵盤 ← → 換步驟、D 顯示說明);投影片用圖(約 2 MB)有六個畫面(開始、第 1 到 5 步),每個都有 PNG 與 SVG。
學習規則與兩組參數出自 flybrain/mb/model.py(檔頭常數 LEARNING_RATE 0.55、DECAY 0.012)與 flybrain/mb/blackjack.py(FlyPlayer 的 lr 0.05、decay 0.00005,與檔尾註解);56/41 出自 out/blackjack/logs/bj1_extract_run1.log。
521 點實驗:規則、牌面怎麼變成氣味、怎麼選、怎麼學
fly-blackjack 的 repo 裡有好幾個實驗,21 點是最後一個。它的讀出(第 1 節的零件 ④)只是一條規則:三個動作各得一個好惡值,選最高的(牌面怎麼變成氣味送進去,是零件 ③ 輸入編碼的事,下面講)。其他三個實驗裡,Dino 和覓食的讀出是接在神經元後面、把活動換成動作、要訓練的小網路(小網路:一小段可調的計算,裡面有幾百個數字要靠反覆試誤調出來;21 點沒有這一段);氣味制約的選邊也用固定規則(兩個好惡值的差換成選那邊的機率),但選完就結束,不從選的結果學。所以 21 點是唯一不用訓練讀出、又要從自己選的結果學習的實驗。本課只重現這一個實驗;其他三個第 7 節簡介。
規則。一手牌怎麼進行(押注 → 發牌 → 你的決定 → 莊家補牌 → 結算)和名詞(明牌、軟手、硬手、爆牌、注),第 3 節圖 2 前的「先懂這手牌」已經講過,這裡不重複。作者用的是簡化的 21 點,和一般賭場不同或要特別說的幾條:
- 無限副牌:一副牌 52 張,真賭場用幾副混在一起、抽掉的不會再出現,所以機率會變;這裡相當於每抽一張就放回去,每張牌永遠等機率。所以同一手可能出現兩張一模一樣的牌,甚至五張 A。
- 莊家的打法:你停牌後換莊家翻開蓋牌、抽牌,莊家沒有選擇,不到 17 點一定抽、到了就停;莊家拿到軟 17 也停,不把 A 改算 1 繼續抽。
- 加倍:只在每一手的第一個決定、手上還只有發的兩張時能選。選了就再押一注,莊家只再發一張,拿到後等於強制停牌,接下來和停牌一樣結算,只是輸贏都算兩注。手上點數有利時用,例如 11 點:再抽一張不會爆,抽到 10 就是 21。
- 不能分牌(兩張同點拆成兩手)、不能投降(放棄這手拿回半注)。
- 前兩張就 21 點叫黑傑克,直接贏 1.5 注;莊家也是黑傑克就算平手,只有莊家是黑傑克就直接輸 1 注。
- 玩家爆牌當場輸,莊家不用再補牌;玩家停牌後莊家才照規則補到 17 點以上。平手退回賭注,模型不學。
輸入編碼:牌面變成「氣味」。每一次要做決定時,把五件事各對應到一組固定的投射神經元,疊起來當成一種氣味送進蕈狀體:
| 特徵 | 有幾種值 | 每種值用幾顆 PN | 怎麼排 |
|---|---|---|---|
| 手上點數 | 18(4 到 21) | 26 | 相鄰點數共用 11 或 12 顆 PN,所以硬 15 和硬 14、硬 16 聞起來相近,學到的教訓會帶一點過去(例如硬 14 和硬 15 配要牌、對明牌 8,各亮的 72 顆 KC 共用 49 顆;怎麼排出來的,見表後) |
| 莊家明牌 | 10(2 到 A) | 22 | 同樣的排法,相鄰兩張明牌共用 10 顆 |
| 候選動作 | 3(要牌/停牌/加倍) | 36,而且這些 PN 的活動量是其他特徵的 1.3 倍 | 各組獨立抽,沒有刻意共用;給最多 PN、開最強,因為要學的就是動作 |
| 軟手或硬手 | 2 | 12 | 各組獨立抽,沒有刻意共用 |
| 是不是前兩張 | 2 | 8 | 各組獨立抽,沒有刻意共用 |
點數與明牌的重疊怎麼排出來。點數先把 682 顆 PN 用亂數排成一個順序(像一條隊伍,每顆只出現一次)。18 個點數在這條隊伍上各取連續 26 顆:第 k 個點數(點數 4 是第 0 個)從第 k × 26 × 0.55 個位置開始取(位置從 0 數起),小數捨去,所以起點是 0、14、28、42、57……最後一個是 243;26 × 0.55 = 14.3,小數累積到滿 1 時就多挪一格,所以多數挪 14、每隔幾個挪一次 15。相鄰兩組因此重疊 12 或 11 顆。18 組一共取 468 次,全部落在這條隊伍的前 269 個位置,也就是 269 顆不同的 PN:199 顆被兩個相鄰點數共用、70 顆只屬於一個點數(199 × 2 + 70 = 468);隔一個的兩框起點至少差 28,超過一框的寬度 26,碰不到,所以沒有一顆被三個點數用到(圖 4)。明牌把同樣 682 顆重新亂排一次、排成自己的隊伍,照同樣的算法取(所以明牌和點數會撞到同一顆,下一段的「共用 55 顆」就是這樣來的):每次挪 12 顆(22 × 0.55 = 12.1,捨去小數),10 組取 220 次,落在 130 顆不同的 PN 上,相鄰兩張共用 10 顆。0.55 是作者定的常數,作者的註解只說要讓相鄰點數聞起來相近,沒說為什麼是 0.55。動作、軟硬、前兩張不排列,每個值各自從 682 顆裡亂數抽一組。
Situation 的預設值),作者沒有說明理由;效果是不同打牌種子之間只差發牌與亂選,編碼都一樣。位置由 scripts/encoding_pn.py 照作者 Situation 的抽法算出,存在 out/blackjack/encoding_pn.json;圖由 scripts/make_pn_strip.py 產生。哪些 PN 分給哪個值,由一個固定的亂數種子(給電腦亂數產生器的一個起始數字;同一個數字每次抽出來的結果都一樣,所以可以重現)抽定,之後不再變。被選中的 PN 在單一特徵裡的活動量是 0.7 到 1 之間的一個固定數(也是這個編碼種子抽定的;每個值各抽各的,所以一顆被點數 14 和 15 共用的 PN,在兩個點數裡的活動量不一樣,相鄰點數聞起來相近靠的是用到同一批 PN,不是數值相同),動作那組再乘 1.3,沒被選中的是 0;一顆 PN 被兩個特徵同時選中時兩邊相加,所以活動量可以超過 1。0.7、1.0 與 1.3 這三個數怎麼來,作者在程式註解、README 與 git 紀錄裡都沒有說明;同一個 repo 的 T 迷宮實驗替氣味定強度時用的是另一組範圍(0.45 到 1,再乘 0.85 到 1.15),所以應該看成隨手定的人設。把 0.7 到 1 換掉會不會改變結論,本課實測了,見下面附註「PN 活動的範圍換掉會怎樣」。五個特徵用的是各自的亂數,彼此沒有協調,所以不同特徵的組可以撞到同一顆:實際用到 419 顆,263 顆從頭到尾活動是 0。表上「每種值用幾顆」是一個值的數,整個特徵合起來用的更多:點數 18 個值合計 269 顆、明牌 10 個值 130 顆、動作 106 顆、軟硬 24 顆、前兩張 15 顆。撞得最多的是點數與明牌(共用 55 顆)、點數與動作(38 顆);三個動作的組兩兩之間一共只撞到 2 顆(36 × 3 = 108,扣掉重複的 2 顆就是 106)。一顆 PN 同時屬於兩個特徵時,兩邊的活動相加(算法在 scripts/encoding_pn.py,數字在 out/blackjack/encoding_pn.json)。PN 在真果蠅裡各自對應哪種氣味沒有用到;從資料用到的只有這些 PN 各自連到哪些 KC、連幾個突觸。同一手牌配「要牌」「停牌」「加倍」是三種不同的氣味,所以每個動作各有一個好惡值。
附註:PN 活動的範圍換掉會怎樣(本課實測)
做法。只換作者 Situation 裡 0.7、1.0 這兩個數,其餘逐行照抄;抽亂數的次數不隨範圍改變,所以每個值選中哪些 PN 完全不變,變的只有活動量。比三種範圍:作者的 0.7 到 1;全部 1.0(選中的 PN 一樣強);0.45 到 1(同一個 repo 的 T 迷宮氣味用的強度範圍)。動作那組的 1.3 不動。每種範圍跑完整模型與未訓練(不學、不探索)各 20 個打牌種子 × 30,000 手,比最後 2,000 手。核對:0.7 到 1 那組的 40 局和 PART 4 X1 的 20 個種子逐局相同。
| PN 活動範圍 | 完整模型 | 未訓練 | 學習進步 | 完整模型 − 永遠停牌(95% 信賴區間) | 一致率:完整模型/未訓練 |
|---|---|---|---|---|---|
| 0.7 到 1(作者) | −13.2% | −47.3% | 34.1 個百分點 | +2.7(+0.7 到 +4.6) | 47.9%/45.0% |
| 全部 1.0 | −16.1% | −54.1% | 38.0 個百分點 | −0.2(−2.4 到 +1.9) | 42.4%/45.0% |
| 0.45 到 1 | −15.1% | −38.7% | 23.6 個百分點 | +0.7(−0.9 到 +2.4) | 46.1%/49.2% |
成績是平均每手輸贏(20 個種子的平均);一致率是和基本策略選得一樣的格數比例(第 5 節);永遠停牌是 −15.8%(PART 4)。
不受影響的:有多巴胺、會學,成績才變好。三種範圍的完整模型都比各自的未訓練好 24 到 38 個百分點。
受影響的:「比永遠停牌好一點」和一致率。只有作者的 0.7 到 1 學完明顯比永遠停牌好(信賴區間不含 0);換成另外兩種,差只有 −0.2 與 +0.7 個百分點,信賴區間都含 0,和永遠停牌分不出來。一致率也一樣:只有作者的範圍學完比未訓練高(47.9% 對 45.0%);另外兩種學完反而比未訓練低 2.6、3.1 個百分點。未訓練本身也跟著變(−47.3%、−54.1%、−38.7%),因為沒學之前的好惡值完全由編碼決定。
怎麼讀。作者的 0.7 到 1 在三種裡剛好最好;作者有沒有試過別的範圍才挑它,程式與 README 都看不出來。所以首頁「學到的只比永遠停牌好一點」這句,是在作者這組人設下才成立;換一組同樣說得通的人設,學完就和永遠停牌一樣。本課只試了三種範圍、沒有動 1.3,編碼種子也固定,不能說哪一種範圍「對」。
程式:scripts/pn_amp_check.py(在作者 repo 目錄下執行,逐行照抄作者 flybrain/mb/blackjack.py 的 Situation,只換兩個數);結果在 out/blackjack/pn_amp_check.json,逐局紀錄在 out/blackjack/logs/pn_amp_check.log;永遠停牌的數字與差的信賴區間算法照 out/blackjack/reference_margin.json。
讀出規則:選好惡值最高的動作,偶爾亂選。第 3 節說好惡值正代表想靠近、負代表想躲開;在這裡只比大小:三個動作裡好惡值最高的那個,就是蕈狀體認為該做的;三個值都是正的、或都是負的,也一樣只取最高的,正負本身不用來決定做不做。大部分時候選三個候選動作裡好惡值最高的那個(只在前兩張時才有「加倍」可選)。但每做一個決定,都先擲一次亂數,有一定機率不看好惡值、在這一步能選的動作裡等機率抽一個,叫探索(抽到的可能剛好就是好惡值最高的那個,所以真正「選得和照好惡值不同」的比例比探索機率低)。發牌與亂選用的亂數種子(打牌的種子)和上面編碼用的那個是分開的:換一個打牌的種子就是換一副牌、換一套亂選,PART 4 加種子換的是這一個;編碼的種子從頭到尾不變。一次訓練共打 30,000 手;剛開始每個決定有 35% 的機率探索,之後高出 3% 的那一截每打 3,000 手減半,而且是每手平滑地降(1,500 手時約 25.6%),慢慢逼近 3%(減半的只是高出 3% 的那一截,所以 3,000 手時是 3% + 16% = 19%,不是 35% 的一半)。為什麼需要探索:沒被選的動作從不呈現,它自己的結果永遠學不到;一個起步就偏好「要牌」的蕈狀體,只能靠要牌一直輸、把要牌削低到停牌之下才改選停牌;在那之前停牌完全沒被試過,沒有任何關於停牌的資料,改選過去也不是因為學到停牌會贏。探索讓每個動作從一開始就有機會被試、被學。探索選出的動作和照好惡值選的一樣,一手結束後照樣呈現、照樣學。
探索的細節
作者 FlyPlayer.policy(選動作的那一步)的做法:擲一個 0 到 1 的亂數,小於當下的探索機率就從能選的動作裡等機率抽一個(第一個決定是要牌、停牌、加倍各 1/3,之後的決定是要牌、停牌各 1/2),這時不算好惡值;否則替每個能選的動作各算一次好惡值(不學),選最高的。每個決定各擲各的。探索機率=0.03 + (0.35 − 0.03) × 0.5 ^ (已打手數 ÷ 3,000)(「^」讀作「的……次方」:0.5 的「已打手數 ÷ 3,000」次方,每打 3,000 手,超出 3% 的那部分就減半);已打手數在每手結束時加 1,平手、黑傑克的那手也算。
| 已打手數 | 0 | 1,500 | 3,000 | 6,000 | 9,000 | 15,000 | 30,000 |
|---|---|---|---|---|---|---|---|
| 探索機率 | 35% | 25.6% | 19% | 11% | 7% | 4% | 3.03% |
由 scripts/explore_schedule.py 呼叫作者的 FlyPlayer.exploration() 算出,存在 out/blackjack/explore_schedule.json。
學習:一手結束才回饋。一手牌結束後,贏了就送獎賞多巴胺、輸了送懲罰多巴胺、平手不送:把這手牌裡每個決定(當時的牌面配上當時選的動作)重新呈現一次、同時給多巴胺。選動作時替每個能選的動作各算一次好惡值(探索那次連算都不算),不算呈現,那時不學也不回復。所以 21 點裡一手牌有幾個決定就呈現幾次;平手的那手一次都沒有,既不學也不回復。每一次呈現,依第 4 節的學習規則,減弱的就是那個牌面配那個動作所點亮的 KC 通往 MBON 的連結。輸了削弱的主要是趨近型 MBON 的輸入,這個牌面配這個動作的好惡值就往負走、下次較不會選它;贏了反過來,往正走、下次較會選。多巴胺的強度看輸贏多少:輸贏 1 注是 0.5,加倍後輸贏 2 注是 1.0。黑傑克(前兩張就是 21 點)那手直接結算、沒有做任何決定,所以沒有東西可呈現,不學。一手裡的每個決定分到同樣的回饋——作者在註解裡記了一個曾經踩過的坑:原本讓最後一個決定分到最多,但爆牌那一手的最後一個決定一定是要牌、贏的那一手最後一個幾乎一定是停牌,於是「要牌=輸、停牌=贏」這個全面的關聯淹沒了每一種牌面各自的教訓,模型變成永遠停牌。
回饋分給哪幾個決定的細節
這手的每個決定都受罰(或受獎),不是只有最後一個,而且一樣重。作者 FlyPlayer.outcome(一手結束後回饋的那一步)的做法:這手牌的每個決定都記在一張清單裡,每筆是「當時的局面(點數、手裡的 A 算不算 11 點、莊家明牌、是不是前兩張)+當時選的動作」;一手結束後從最後一個決定往前,一個一個重新呈現,每次都送同樣強度的多巴胺(輸 1 注是懲罰 0.5,加倍後輸是懲罰 1.0)。每個決定的強度要乘上一個權重:權重=credit_decay 的 i 次方,i 是從最後一個往前數的第幾個(最後一個是 0)。credit_decay 預設 1.0,所以權重全是 1;本課跑的程式(下載包裡的 blackjack/scripts/)都沒有改這個值。作者早期版本用的是 0.7 的 i 次方,越後面的決定分到越多,就是上面講的那個坑(程式見 PART 6 第 7 節)。
拿到幾張牌,不等於做了幾個決定。開局的兩張牌不用決定;之後每一次要牌、停牌或加倍才算一個決定。例如玩家手上最後是三張牌、輸了:如果是第三張牌爆了,只有 1 個決定(要牌),它受罰;如果第三張沒爆、接著停牌、比莊家小,就有 2 個決定(要牌、停牌),兩個都受罰、一樣重。手上五張牌輸了,就是 3 或 4 個決定,同樣全部受罰。一開始就加倍的那手只有 1 個決定(加倍),拿一張牌就結束。
評模型打得好不好的標準有兩個:勝率與一致率。先講勝率(作者的用詞;其實是平均每手的淨輸贏,不是贏的場數比例):以一注為單位寫成百分比,−16% 就是平均每手輸 0.16 注。21 點對莊家本來就是輸的(你先抽、先爆就先輸,不管莊家後來爆不爆),所以勝率都是負的,愈接近 0 愈好。在這套規則下的三個對照值(作者程式算的,存在本課實跑輸出 out/blackjack/bj2_blackjack_30000.json 裡):照基本策略(賭場數學算出來、公開的最佳打法表,下面講一致率時細講)打是 −1.4%、三個動作亂選是 −44.5%、永遠停牌是 −15.8%。這三個數不是精確算出來的期望值,是作者程式的參考打法各實打 20,000 手的平均,各帶約 ±1.4 到 ±1.8 個百分點的誤差(95%);所以拿模型和它們比時,兩邊的誤差都要算進去(例如完整模型比永遠停牌好多少,見下面「勝率和這個答案一致嗎」)。
作者 README 寫的數字。完整模型(有學習、有探索的正常訓練)勝率 −16%,是作者三個種子的平均;未訓練 −45%、切斷多巴胺 −46%(本課用同一批 KC 自己重跑:未訓練 3 個種子平均 −48.0%、20 個種子平均 −47.3%,見 PART 3、PART 4)。這些勝率都取那 30,000 手裡的最後 2,000 手平均:要量的是學完之後的水準,頭幾千手還在學、還有很多亂選;未訓練不學也不亂選,照樣打 30,000 手、取最後 2,000 手,是為了和其他條件用同一把尺比。
每個條件是什麼。未訓練是不學、不探索,直接照起始的好惡值選,從頭到尾沒有亂選;切斷多巴胺是照樣打 30,000 手、照樣探索,但輸贏不送多巴胺,所以學不到東西,成績和未訓練幾乎一樣(只多了亂選:本課 3 個種子平均,切斷多巴胺 −47.5%、未訓練 −48.0%,差 0.5 個百分點);完整模型與切斷多巴胺那兩組的最後 2,000 手裡還有約 3% 的決定是亂選的。
和三個對照值比。作者 README 的未訓練 −45% 和亂選的 −44.5% 接近(本課重跑的未訓練是 −47.3%,比亂選還差約 3 個百分點),是兩種不同打法剛好差不多:前者幾乎每種牌面都要牌、常爆(為什麼沒學過就偏要牌,本節後面「未訓練的對照值」那段講),後者亂選。完整模型的 −16% 則和永遠停牌的 −15.8% 幾乎一樣,也就是說學完的成績和「永遠停牌」差不多(本課 20 個種子的平均略好一點,見本節末)。
再講一致率。基本策略是賭場數學算出來、公開的一張表,寫明每種情況該怎麼打:把莊家每一種明牌(2 到 A,10 種)× 自己每一種可能的手牌(硬手 5 到 21 點 17 種、軟手 13 到 21 點 9 種,共 26 種)排成 260 格,每格填「要牌」「停牌」或「加倍」。訓練結束後,不亂選、每格照好惡值最高的動作填出模型自己的 260 格表(填表時每格都當成前兩張、三個動作都可選,和基本策略表同一條件),和基本策略那張表有幾格相同,就是一致率。所以一致率只看每手的第一個決定;手上三張以上時的決定(之後的 162 種局面)不在表上,本課也沒有另外評它們。模型看得到的手牌比 260 格多兩種:硬 4(兩張 2)和軟 12(兩張 A),只在開局拿到一對時出現,基本策略表慣例不列它們。原因是賭場的規則通常可以分牌,所以公開的基本策略把對子另列一張表,專門決定拆不拆;硬手、軟手那兩張表只給不是對子的兩張牌用。兩張 2 是湊成硬 4 的唯一組合、兩張 A 是湊成軟 12 的唯一組合,在標準表裡全歸對子表,所以硬手從 5 起、軟手從 13 起(作者排 260 格的 chart_cells 照這個慣例寫死)。別的對子在硬手表裡另有不是對子的組合,格子還在:例如兩張 3 是硬 6,那一格給 4+2 用。這套規則不能分牌,牌面編碼裡也沒有「是不是對子」這一項,所以兩張 3 和 4+2 對模型是同一種氣味;硬 4、軟 12 也只是普通的牌面,模型照樣打、照樣學,只是不算進一致率。上面編碼表的點數從 4 起,就是為了硬 4。反過來,表上硬 21、軟 21 兩列共 20 格在「前兩張」的條件下不可能出現:兩張牌湊不出硬 21,兩張就 21 是黑傑克,直接結算、不做決定。但要牌補到 21 點之後,程式不會自動停牌,模型還得再選一次(這時不能加倍);每個種子 30,000 手裡有 186 到 1,050 次這種決定,要牌常常輸(硬 21 再要必爆),模型就學到停牌。評分格和這個情況只差「是不是前兩張」那一組 PN,學到的會直接帶到評分格上(硬 21、軟 21 兩列 20 格要牌後才會遇到的次數、評分格各選什麼,由課程倉庫的 scripts/row21_visits.py 算出,在 out/blackjack/row21_visits.json)。所以這 20 格量到的是「21 點還要不要牌」,不是「前兩張的 21 點怎麼打」。作者 README 寫的一致率是 52%。
一致率能看出什麼、看不出什麼。基本策略那 260 格裡,要牌 115 格、停牌 106 格、加倍 39 格。一致率的對照值(拿來比的基準)用兩個:未訓練與永遠停牌。勝率那段的亂選這裡不用,因為亂選每次填出的表都不同,沒有固定的一致率。未訓練(README 那個條件,勝率 −45%)的一致率是 45.0%:它 260 格裡 239 格選要牌;該要牌的 115 格裡有 106 格對上,該停牌的 106 格裡對上 11 格,該加倍的 39 格一格都沒對上,共 117 格(117 ÷ 260)。永遠停牌的一致率是 40.8%:只對上該停牌的那 106 格(106 ÷ 260)。學完的:本課 20 個打牌種子從 40.8% 到 59.2%,平均 47.9%(PART 4 的 X1);作者 README 寫 52%。45.0% 作者沒寫,是本課用作者切出來的那份連結體檔案、作者自己算一致率的程式算的,和本課算學完的一致率(47.9%、51.9% 等)用的是同一支程式、同一張基本策略表。最低那個 40.8% 等於 106 格,和永遠停牌對上的格數碰巧相同,但那張表(種子 18)不是全部停牌:要牌 36、停牌 187、加倍 37 格。
平均來看,一致率有沒有上升。260 格全算的話有小幅上升,但這個上升全部來自硬 21、軟 21 那 20 格。同一批 KC 未訓練是 45.0%,學完的 20 個種子平均 47.9%,95% 信賴區間 46.1% 到 49.7%(信賴區間:只跑了 20 個種子,算出的平均帶著誤差,這個區間是「跑無限多個種子的平均」大概落在的範圍),區間不含 45.0%。但硬 21、軟 21 兩列(20 格)學到的只是「補到 21 點別再要牌」(上面講過),而基本策略在這兩列都是停牌,所以學完多對上十幾格(20 個種子這兩列停牌 17 到 20 格,未訓練只有 6 格)。扣掉這 20 格只看 240 格:未訓練 46.25%(111 格),學完的 20 個種子平均 44.4%(95% 信賴區間 42.3% 到 46.4%),20 個裡 14 個比未訓練低、1 個相同、5 個較高。也就是說,在其餘 240 格(以前兩張出現、會照基本策略逐格比的那些格),學習沒有讓一致率上升:學完的區間包含未訓練的 46.25%,兩者分不出差別,點估計還略低。這是對同一批 KC 而言;換一批 KC,未訓練的基準就不是 45.0%(本節後面「未訓練的對照值」那段)。學完的表以停牌為主,一致率平均卻沒有掉到永遠停牌的 40.8%(最低的種子 18 剛好 40.8%,但它的表不是全部停牌,上面說過),是因為多出來的加倍格有一部分對上(永遠停牌在加倍格一格都對不上):種子 0 對上的 114 格是停牌 101、加倍 11、要牌 2。
只看一次訓練,為什麼看不出來。種子之間從 40.8% 到 59.2% 都有,種子 0 的 43.85% 甚至比 45.0% 低。所以只看一次訓練的一致率,看不出學沒學(PART 3 第 5 節說「分不出學沒學」,指的就是這件事)。一致率只數動作相同的格數,不看每一格值多少錢;學到的東西要看勝率。
模型學到什麼:三份東西分開看。作者附的大腦檔是作者 repo 裡附的一份訓練完的模型存檔(學完之後的增益;檔內標明是種子 0、30,000 手)。三份東西各說模型學到什麼:
| 來源 | 要牌/停牌/加倍(格) | 一致率 |
|---|---|---|
| 作者 README 的文字 | 「別爆牌」:幾乎每種牌面都停牌,只在 10 和 11 點要牌 | 52% |
| 作者附的大腦檔 | 97/149/14 | 51.9%(用作者的程式評分) |
| 本課重跑,打牌種子 0 | 6/214/40 | 43.85% |
| 本課重跑,打牌種子 1 | 12/212/36 | 44.62% |
| 本課重跑,打牌種子 2 | 62/176/22 | 47.31% |
三份彼此對不上。README 自己就對不上:照它的文字(只在硬 10、硬 11 要牌,其餘停牌)填 260 格,一致率是 41.9%(109 格),不是 52%。另外,作者的存檔有 97 格要牌,和他 README 的「幾乎都停牌」不合。本課重跑的 20 個種子都以停牌為主,要牌卻從 6 格到 111 格都有:存檔的 97 格在這個範圍內,README 的「幾乎都停牌」只描述得到其中要牌少的那幾個。對不上的是存檔自己標明的種子 0:本機種子 0 只要牌 6 格(20 個種子裡最少的),兩張表在 260 格裡有 114 格不同(碰巧也是 114,和上面種子 0 對上基本策略的 114 格是不同的比較)。種子、連結體檔、程式看起來都相同,卻得到不同的表;最直接的解釋是作者的存檔由另一個版本或另一組設定的程式產生,但作者沒有記錄,本課無法確認(PART 3 第 5 節)。本課用的是作者最後的程式,已含「學習」那段踩坑後的修法(每個決定分到同樣的回饋):踩坑時模型變成永遠停牌;修法之後仍以停牌為主,但多了幾格到一百多格要牌、幾格到五十多格加倍。本課另外跑了 20 個打牌種子(種子 0 到 19,含上表三個);PART 4 原本只記了勝率與一致率,本課後來把 20 個種子重打一次、存下逐格的表(勝率與一致率和原本逐位相同)。大腦檔的檔內另記了 53.1%,由作者另寫的網頁版 21 點(在瀏覽器裡跑的版本)的評分程式算出,兩套評分程式對同一份存檔差 3 格,原因本課沒有追;README 的 52% 怎麼算的作者沒寫,51.9% 取整後碰巧相同(PART 3 第 5 節)。
未訓練的對照值隨抽到的 KC 變,不隨打牌種子變。(不隨種子變的是未訓練的打法表與一致率;成績仍會因為發到的牌不同而晃,所以未訓練 3 個種子平均 −48.0%、20 個種子平均 −47.3%。)這段回答兩件事。第一,沒學過為什麼偏要牌:三個動作的編碼規則一樣,沒有哪條規則偏好要牌;起始好惡值只由亂數分給三個動作的 PN 和抽到的那批 KC 決定,偏向只能從這兩者來。這裡要分兩件事。偏向哪一個動作:是這次分 PN、抽 KC 的偶然結果,1.3 不決定這件事(1.3 三個動作都乘,不偏袒哪一個)。偏得這麼一致(260 格裡 239 格都是要牌):本課推測是 1.3 把這個偶然放大了:動作那組是最強的輸入(36 顆、又乘 1.3),而同一個動作在每一格用的都是同一組 PN,它帶出的偏向就蓋過牌面那部分、在幾乎每一格都出現;這一層是推測,本課沒有拆開驗證。換一批 KC,未訓練的一致率就跟著變(換了之後是不是仍偏要牌,本課只存了一致率、沒查逐格的表):PART 4 的 X3 換的四批(全部 3,811 顆,以及隨機抽 1,200 顆三次)落在 40.8% 到 49.2% 之間(最低的 40.8% 也等於 106 格,那張表長什麼樣本課沒查),所以這個對照值本身帶著幾個百分點的偶然。它與打牌種子無關:未訓練不學也不亂選,填表只看起始好惡值,而起始好惡值只由編碼種子和抽到的 KC 決定,同一批 KC 不管哪個打牌種子,一致率都是 45.0%。第二,上表種子 0 的一致率 43.85% 比同一批 KC 未訓練的 45.0% 還低,為什麼不代表學壞了:一致率只數格數、不看每格值多少錢,低 3 格(114 對 117)不代表打得更差;勝率上,種子 0 的 −15.0% 比本課重跑的未訓練(20 個種子平均 −47.3%)好得多。另外,未訓練的一致率 45.0% 和作者寫的未訓練勝率 −45% 是兩個不同的量,數字相同只是巧合。
本頁的答案:這個模型到底學到什麼?看本課重跑的 20 個種子(作者的存檔來歷沒有記錄,不拿來下結論):每一個都以停牌為主(停牌 141 到 231 格),但要牌從 6 格到 111 格、加倍從 8 格到 53 格,種子之間差很多;沒有一張「學到的表」,只有一個共同的方向:從幾乎全要牌,往停牌為主移動。為什麼會收斂成這樣、為什麼每個種子停在不同的地方,本課沒有查。這個結果和第 4 節說的「全面的教訓」(不分牌面的「要牌常常輸」)相容:PART 5 看到,削弱一個牌面的要牌會擴散到別的牌面;學到的有多少是全面的教訓、多少是逐格學到的,本課沒拆開驗證。所以第 4 節那個修法(回復放慢、每個決定分到同樣的回饋)到底有沒有用,要分兩半說:它讓模型不再變成「全部停牌」,這有看到;它有沒有帶來逐格的學習,現有證據分不出來,除了「補到 21 點別再要牌」這一項,逐格的一致率沒有上升(下兩段)。一致率最高的種子 16(59.2%)要牌 111 格,是 20 個裡最多的;勝率最好的種子 15(−5.0%)要牌 64 格。和作者 README 的文字描述「幾乎都停牌」比,只有要牌少的那幾個種子相近,而且本課的表都有加倍格,README 沒提加倍。
勝率和這個答案一致嗎。一致:勝率也接近永遠停牌,只略好一點。本課跑了 20 個種子,每個取最後 2,000 手的勝率,從 −17.8% 到 −5.0% 都有(最好的 −5.0% 是種子 15:要牌 64、停牌 163、加倍 33 格,看不出和別的種子有什麼明顯不同;20 個種子的要牌格數和勝率也看不出關係),平均 −13.2%。單一種子的 2,000 手勝率本身就帶著約 ±5 個百分點的抽樣誤差(標準差是每手輸贏離平均通常差多少,種子 0 最後 2,000 手是 1.19 注;手數愈多,平均愈穩,95% 的誤差範圍約是 1.96 × 標準差 ÷ √手數,這裡 1.96 × 1.19 ÷ √2000 ≈ 0.052),所以種子之間十幾個百分點的差距,有一部分只是發牌運氣。這個平均的 95% 信賴區間是 −14.5% 到 −11.8%,比永遠停牌的 −15.8% 好約 2.7 個百分點(用沒四捨五入的兩個平均相減;四捨五入後相減看起來是 2.6);把永遠停牌本身的模擬誤差也算進去,差距的 95% 區間是 0.7 到 4.6 個百分點,不含 0。好在哪幾格,本課沒有逐格拆開算過。直覺會猜是加倍格換來的(種子 0 有 40 格加倍),但上表三個種子裡,加倍最少(22 格)、要牌最多(62 格)的種子 2 勝率是 −12.9%,和其他兩個種子的差距都在上面說的 ±5 個百分點之內:看不出加倍格的多寡和勝率有關(20 個種子也一樣,要牌格數和勝率看不出關係),要斷定得逐格算每格值多少,本課沒做。作者的 −16% 是他三個種子的平均,略低於這個區間;但單一種子就差到十幾個百分點,三個種子的平均也會晃,所以 PART 3 第 5 節比的不是精確數字,而是幾組之間的相對關係:有學習的完整模型停在 −15% 左右,明顯好過未訓練與切斷多巴胺兩組的 −45% 左右;學不到東西的兩組則彼此差不多。照這個標準,勝率對上了(本課種子 0、1、2 是 −15.0%、−16.4%、−12.9%;作者存檔裡記錄的是 −17.86%);學到的策略則對不上(本課重跑的表和作者附的存檔不像)。PART 5 列出本課重跑是哪幾格要牌(其中軟 21 對 6 那一格選了要牌,看起來像學錯,但不能這樣解讀:硬 21、軟 21 兩列在「前兩張」時從不出現,評分格是從補到 21 點後的決定借來的;而軟 21 要牌不會爆(A 改算 1),輸得少,學得不像硬 21 那麼穩,見本節講一致率那段)。
出現過幾種局面、照 README 文字打法的一致率、單一種子 2,000 手勝率的抽樣誤差,以及第 4 節 MBON 收到哪幾群多巴胺的顆數,由課程倉庫的 scripts/part1_extras.py 算出(out/blackjack/part1_extras.json)。20 個種子的逐格表(各動作格數、扣掉硬 21、軟 21 兩列後的一致率)由 scripts/seeds20_tables.py 重打存下(out/blackjack/seeds20_tables.json)。21 點的規則、編碼、探索時程、回饋強度與基本策略表出自 flybrain/mb/blackjack.py(Situation 的 WIDTH、FlyPlayer 的 explore 參數、outcome(),以及 basic_strategy();PART 6 逐行讀它)。
6總表:哪些來自資料、哪些是人為設定
| 零件 | 21 點裡的樣子 | 資料還是人設 |
|---|---|---|
| ① 連結體 | MaleCNS v1.0 切出的四群共 2,311 顆、四層連結,每條的突觸數照資料 | 資料;但 KC 只取路徑上 3,811 顆中的 1,200 顆是人選的 |
| ② 神經元方程式 | KC 只留最高 6%、MBON 加權總和、好惡值 | 人設的算法;連結一律當成推高(作者的選擇,見第 3 節的白話) |
| ③ 輸入編碼 | 牌面五個特徵各對應一組固定的 PN,疊成一種「氣味」 | 人設(哪些 PN 分給哪個值由固定種子抽定;PN 活動 0.7 到 1、動作那組乘 1.3 也是人設) |
| ④ 讀出規則 | 選好惡值最高的動作,加探索;好惡值的正負靠 MBON 的 ±1 標記 | 選法是人設;標記一半資料(數突觸)一半人設(「PPL1 多=趨近」的對應規則) |
| 學習 | 一手結束才回饋:KC→MBON 的增益依多巴胺削弱 | 規則的方向照文獻;學習率 0.05、回復速度 0.00005、多巴胺強度(輸贏 1 注 0.5、2 注 1.0)、一次訓練 30,000 手、探索時程(35% 起、每 3,000 手超出 3% 的部分減半)都是人設 |
表中數字的出處同第 2 到 5 節;2,311 = 682 + 1,200 + 97 + 332。
作者在 README 裡列了同樣意思的清單,也寫明他的模型不是「上傳了一隻果蠅」。上面這張〈總表〉是後面幾個 PART 的地圖:PART 3 檢查的是「照這四個零件組起來打 21 點,能不能得到作者的數字」;PART 4 則開始動零件 ①——打亂某一層接線、換一批 KC,另外多跑幾個打牌種子(這一項不動零件,只換發牌與亂選),看結論還站不站得住;PART 5 把那 30,000 手錄成影片,逐手看零件 ②③④ 怎麼一起運作;PART 6 把每個零件對到程式的哪幾行。
7repo 裡的另外三個實驗(本課不重現,只簡介)
作者的 README 分五部分,21 點是最後一部分;第二部分是會走路的身體模型(要物理引擎),本課不碰。其餘三部分各是一個實驗,作者用它們一步一步證明零件能用;本課不重現它們,這裡只說每一個在做什麼、和 21 點差在哪,讓你讀作者的 README 時對得上號。它們的數字不出現在本課其他頁面。
| 實驗 | 在做什麼 | 和 21 點差在哪 |
|---|---|---|
| Dino(README part one) | 一個像 Chrome 離線小恐龍的小遊戲:角色一直往前跑,靠跳或蹲躲障礙物。作者從同一份連結體另外挑 80 顆神經元(32 顆收畫面、32 顆中間、16 顆往身體送指令的下行神經元),接線照連結體,後面接一個 243 個參數的小網路(叫讀出)決定跑、跳、蹲;只有這個小網路被訓練,接線不動 | 用的不是蕈狀體;沒有多巴胺、沒有本頁第 4 節的學習規則。它證明的是「真實接線加一個訓練過的讀出」能做事 |
| 氣味制約(README part three) | 用本頁第 2 到 4 節的同一個蕈狀體:給一種氣味時電擊、另一種不電,重複 20 次,量兩種氣味的好惡值差了多少(學習指數);另外讓 100 隻模擬果蠅在兩種氣味之間選邊(T-maze) | 選邊照兩個好惡值的差用固定公式換成機率,選完不學,學習率與回復速度用另一組(0.55、0.012)。它證明的是學習規則能學氣味,是 21 點的前置實驗 |
| 覓食(README part four) | 同一個蕈狀體接到一隻會在平面場地裡走的模擬果蠅上:兩個氣味源,一個有食物、一個會電擊,蕈狀體在一場之內學哪個氣味危險;走路由 Dino 那個 80 顆迴路加另一個讀出控制 | 多了一個要用 CEM(一種訓練法:每一代隨機抽幾十組參數、留下表現最好的再抽)訓練的走路讀出與一個場地,蕈狀體只學懲罰。它證明的是學到的好惡值能真的影響行為 |
三個實驗的設定出自作者的 README(out/upstream/blackjack_README.md)與 flybrain/ 底下的 train.py、mb/experiment.py、mb/tmaze.py、mb/embodied.py。repo 裡另有撲克的嘗試,本課也不碰。