1三種「對上」
先說這一頁在對什麼。fly-blackjack 是一個人(本頁叫他作者)放在 GitHub 上公開的一包程式(repo:那個公開的程式資料夾;README:資料夾裡作者寫的說明與結果摘要),它拿果蠅腦的接線資料去學打 21 點(是什麼、怎麼學,見 PART 1)。本頁把那包程式裡 21 點這個實驗在自己的電腦上(本機)重跑一次,分三步,每一步把跑出來的數字對回作者寫的數字。
重現的每一步都要先回答:本機的數字要和作者的差多少以內,才算對上?答案取決於那一步有沒有隨機性、隨機性有沒有被固定住。重現型的專題一律用三種判定標準:
| 判定標準 | 什麼時候用 | 本頁哪些步驟(BJ1 到 BJ3 是下面三個步驟的代號,本課自己編的) |
|---|---|---|
| 逐位相同:檔案一個位元都不差;數字則到作者給出的位數為止每一位都相同 | 這一步沒有隨機性,或隨機性由亂數種子完全固定(種子 seed 是給電腦隨機數產生器的起點;起點相同,抽出來的整串隨機數就相同,所以「隨機」的過程也能重做得一模一樣) | BJ1 切出的蕈狀體(檔案指紋、細胞數、連結數);BJ3 的比對 (a):把作者附的大腦檔(作者訓練完存下來的模型狀態檔)重新評分(評分=算它在基本策略表裡選對幾格;基本策略是一張公開、事先算好的「每種牌面該怎麼打」對照表,共 260 格,拿來當標準答案,PART 1 第 5 節;評分沒有隨機性),對檔內記錄的值。(BJ3 的另一個比對 (b) 事先也訂在這一類,事後看是訂錯的,表下單獨說明) |
| 在誤差範圍內:與作者的值相差不超過一個事先訂好的比例 | 這一步的隨機輸入在不同電腦上不保證相同 | 本課沒有用到:21 點的發牌與探索(模型每做一個決定都有一定機率隨機亂選動作,本頁第 4 節)都固定了種子。但固定種子只保證「同一份程式在同一個環境」能重做;作者跑出那些數字時用的程式版本與環境沒有記錄(本頁第 5 節),所以種子相同也不預期和作者逐位相同,BJ2 改比形狀(下一列) |
| 形狀相同:條件之間的高低順序與差距方向一樣 | 數字本來就不會一樣,或作者只給了取整的數字 | BJ2 的成績:作者只給整數百分比、程式版本與環境沒有記錄,而且本機三個種子彼此就差好幾個百分點,取整後也比不出東西 |
先定名字。模型的材料是連結體(整隻果蠅腦「哪顆神經元接到哪顆、接了幾個突觸」的完整表格;突觸是兩顆神經元之間傳訊號的接點)切出來的蕈狀體接線,學習靠多巴胺(腦裡傳「好事或壞事」的化學訊號);學習規則是「多巴胺來了,就削弱正在活動的輸入連結」,細節在 PART 1 第 4 節。獎賞和懲罰都只削弱,分得出輸贏是因為兩種多巴胺送到不同的輸出神經元(MBON):模型替每個動作算一個好惡值(各輸出神經元的活動照趨近加分、迴避扣分加總,選最高的那個動作,PART 1 第 3 節);懲罰主要送到「趨近型」MBON,削弱後這個動作的好惡值下降;獎賞主要送到「迴避型」,削弱後好惡值上升。懲罰送到「想靠近」那一型乍看是反的,但因為學習只會削弱:削弱「想靠近」,等於讓這個動作變得不想做,所以方向是對的。21 點跑四個條件:完整模型是作者表格裡的「連結體 + 多巴胺」,什麼都沒拿掉;其餘三個合稱對照組:未訓練(不學、不探索)、關掉學習(多巴胺照常送到,但不執行學習規則)、切斷多巴胺(多巴胺神經元到輸出神經元的連結設成 0,學習規則收不到訊號;每顆 MBON 是趨近型還是迴避型,在作者切蕈狀體時就算好、存在檔案裡,切斷多巴胺不會改變它)。
BJ2 怎麼判。BJ2 比成績(作者叫它勝率,其實是平均每手的淨輸贏,本頁第 4 節):數字是負的,愈接近 0 輸得愈少,所以 −45% 變 −16% 叫「升」。作者只在程式註解裡給了取整數的百分比(−16% 是他 3 個種子的平均),而且單一種子的成績上下差好幾個百分點(本頁第 4 節),取整後比不出東西,所以比的是形狀:完整模型升到作者寫的水準,對照組「不動」。「不動」事先定義成「留在未訓練那一帶、不往上走」,上下飄幾個百分點不算動,因為作者自己的對照組也落在 −45% 到 −47% 之間(切斷多巴胺那列從 −46% 到 −47%)。這裡的界線有方向:往上走就算動,往下掉幾個百分點不算;「幾個百分點」事先沒有訂上限,和下面的「升到作者寫的水準」一樣,是本頁的限制,判定時兩個有探索的對照組掉了約 5 個百分點,本頁算它們不動。「升到作者寫的水準」事先沒有訂成數字範圍,這違反了上面「跑之前訂」的原則,算本頁的一個限制;判定時才補的標準是三個種子都落在作者 −16% 附近、而且遠離對照組的 −45% 一帶。(事後的結果在本頁第 4 節。)
BJ3 怎麼判。BJ3 比一致率(模型在基本策略表的 260 格裡選對幾格的比例;260 格=莊家(發牌、和你比點數的那一方)翻開的那張牌(明牌,10 種)× 自己 26 種手牌(硬手 5 到 21 點 17 種、軟手 13 到 21 點 9 種;A 可以算 1 點或 11 點,手裡有 A 而且 A 算 11 點叫軟手,沒有 A 或 A 只能算 1 點叫硬手;J、Q、K 都算 10 點,所以明牌只有 2 到 10 和 A 共 10 種),每格寫著該要牌(再拿一張)、停牌(不拿了)還是加倍(加一注、只能再拿一張),點數超過 21 叫爆牌、直接輸,PART 1 第 5 節),兩個比對:(a) 作者附的大腦檔重新評分,對檔內記錄的值,評分沒有隨機性,要逐位相同;(b) 本機重跑三個種子的平均一致率,對 README 寫的 52%,README 只給整數,就比到整數位。(b) 是照 README 給的精度訂的;照 BJ2 的同一套理由(作者的程式版本與環境沒有記錄、三個種子彼此差到 3.5 個百分點:43.85%、44.62%、47.31%,本頁第 5 節),這一項其實也不該期待逐位對上,是事先訂錯的標準。本課保留它、照實寫「對不上」,是為了誠實記錄事先訂了什麼;這一項本身說明不了多少,跑完的結果與理由在本頁第 5 節。
本節的出處:白話框裡的骰子是說明用的例子,不是實驗數字;作者的數字(−45%、−16%、52% 等)出自作者 repo 的 README 與 blackjack.py 檔尾註解(收在 out/upstream/),本機重跑的數字見本頁第 4、5 節的出處。
2結論:三個步驟的成績
| 步驟 | 做什麼 | 判定標準 | 結果 |
|---|---|---|---|
| BJ1 | 下載資料、切出蕈狀體(果蠅腦裡負責學氣味好壞的一小塊,本頁第 3 節),跑兩次、比 md5(檔案指紋,內容一樣指紋才一樣) | 細胞數、連結數與作者的兩份紀錄(README、作者 repo 裡切完自動存下的紀錄檔)相同;兩次 md5 相同(訂標準時沒有先核對兩份紀錄彼此一不一致,跑完才發現它們不合,所以「和 README 相同」這一半事先就做不到) | 和紀錄檔:細胞數、連結數全部相同;兩次 md5 相同。和 README:兩個連結數對不上,而且 README 和作者自己的紀錄檔也不一致;本課查出 README 的兩個數是資料裡全部 4,064 顆 KC、不篩也不取樣時的連結數,逐位吻合(本頁第 3 節;模型讀的是檔案,不影響結果)。作者沒附他的 md5,跨電腦只能比到數量這一層 |
| BJ2 | 21 點 30,000 手,四個條件各 3 個種子 | 成績形狀相同:完整模型升到約 −16%、對照組不動 | 形狀相同(完整模型 −14.8%;兩個有探索的對照組掉了約 5 個百分點、未訓練最後 2,000 手 −48.0%、頭尾差不多,三者都沒有上升) |
| BJ3 | 把作者附的、打過 30,000 手的大腦檔載入作者的程式重新評分 | 與基本策略(一張公開的「每種牌面該怎麼打」的表,PART 1 第 5 節)的一致率:(a) 大腦檔重新評分,和檔內記錄的值逐位相同;(b) 本機重跑三個種子的平均,和 README 的 52% 比到整數位 | (a) 對不上:重新評分 51.9%,檔內記錄 53.1%,差 3 格,原因沒追;51.9% 取整後碰巧等於 README 的 52%。(b) 對不上:本機重跑是 45.3%(三個種子平均;種子 0 是 43.8%)。另外大腦檔標明是種子 0,本機種子 0 的表和它有 114 格不同(碰巧和種子 0 選對的格數同數);20 個種子學完要牌 6 到 111 格,每個種子都不同。另外:未訓練 45%、學完 45.3%,一致率分不出學沒學;作者自己的三份資料(52%、48.1%、53.1%)也互相矛盾 |
每一列的數字出處見下面對應的小節。表裡三處對不上:BJ1 一處(README 的兩個連結數)和作者自己的紀錄檔不一致,本課查出它們是全部 KC 不篩時的數字,模型讀的是檔案,不影響任何結果;BJ3 兩處,(a) 是同一個大腦檔兩套評分程式差 3 格,(b) 是本機重跑的一致率對不上 README。這一頁的主要發現有兩個,都在本頁第 5 節。第一,作者附的大腦檔重現不出來:它標明是種子 0,公開程式用種子 0 學出的表和它有 114 格不同(大腦檔要牌 97 格、本機 6 格),而同一份程式同一個種子重跑是逐位相同的。第二,「學到什麼策略」不是一個固定的答案:20 個種子學完,要牌從 6 格到 111 格都有,只有「以停牌為主」是共同的;大腦檔的 97 格也在這個範圍內。(b) 對不上只是輔助,因為「一致率本身分不出學沒學」。
BJ1–BJ3 是本課自己編的代號。本頁會提到三個資料夾,先分清楚:
- 作者的 repo:fly-blackjack 的程式碼,
run_all.sh第一步自動從 GitHub 抓下來。 - 下載包:PART 2 教你抓的本課程式資料夾,裡面的
blackjack/run_all.sh照 BJ1 到 BJ3 的順序執行;跑完後每一步的終端輸出在你電腦的logs/、數字在results/。指令、要跑多久、跑完先看什麼,在 PART 2 第 1 節與第 7 節。 - 課程網站的程式倉庫(GitHub 上的 marginli/bsc-flyblackjack):本課自己實跑的那一份 logs 與 results 收在它的
out/資料夾;下載包裡沒有 out/。本頁寫「出自 out/…」指的都是這一份,給想核對的人用。對應規則:out/blackjack/logs/某檔就是你的logs/某檔,out/blackjack/裡和你的results/同名的 .json 就是同一份(其餘的 .json 是本課另外算的);out/upstream/是從作者 repo 抄出來的原文,scripts/(例如產圖的make_figures.py)是這個倉庫自己的程式,兩者都不在下載包裡。
作者的 21 點程式沒有命令列入口(沒有一條可以直接在終端機打的指令;作者是在 Python 裡呼叫函式、或用他的網頁版跑的),下載包的 blackjack/scripts/ 補了兩支小程式去呼叫作者的函式(不改作者的程式)。
3BJ1 下載並切出蕈狀體:md5 相同,README 的兩個連結數是沒篩 KC 時的數字
先認識這一步的材料。連結體是整隻果蠅腦「哪顆神經元接到哪顆、幾個突觸」的完整表格;蕈狀體是其中負責學「這個氣味是好是壞」的一小塊,模型從它切出四群神經元:氣味輸入 PN → 把氣味編成代碼的 KC → 輸出 MBON,加上告訴它賞或罰的多巴胺神經元 DAN(PART 1 第 2 節)。BJ1 驗的是「切出蕈狀體」這一步能不能一模一樣地重做。作者程式裡負責下載的那一段 flybrain.mb.fetch(一個 Python 模組,PART 6 逐行讀)從 connectome_data_prep(另一位研究者 Yijie Yin 在 GitHub 上公開的整理版,把 MaleCNS(一份公開的雄果蠅全腦連結體資料集的名字)連結體存成可以直接讀的表格)下載連結矩陣(哪顆神經元連到哪顆、幾個突觸),下載完核對檔案大小與筆數(PART 2 第 5 節);負責切的那一段 flybrain.mb.extract 從裡面切出 PART 1 第 2 節表裡的四群神經元(PN、KC、MBON、DAN),存成一個檔 data/mb_circuit.npz。README 宣稱這個切法在任何電腦上都逐位相同(在不同電腦上切出來的檔案應該一模一樣、md5 相同),但作者沒有附上他自己算出的 md5 值。所以能驗的是兩層:第一層在同一台電腦上跑兩次、比兩次是否相同(這驗不到「跨電腦」);第二層把切出來的細胞數與連結數對回作者存進 repo 的紀錄檔。跨電腦能做的比對在你手上:你照 PART 2 跑完,驗收程式 check.py 會拿你的 md5 去比本課的 32dc49359f237250162ed33dcb5da93c,對上了就是兩台電腦切出的檔案逐位相同;對不上代表你的環境切出了不同的檔,那一項會標 ✗。比檔案不必逐條比對幾萬條連結,比 md5 就夠了:md5 是從整個檔案算出來的一串指紋,內容只要差一個位元,指紋就完全不同。本課跑兩次、比兩次的 md5:
32dc49359f237250162ed33dcb5da93c  data/mb_circuit.npz
32dc49359f237250162ed33dcb5da93c  data/mb_circuit.npz
兩次相同(第一層過)。這只證明同一台電腦兩次一樣。跨電腦分兩種:和作者的電腦只能比數量(作者沒附 md5),見下一張表;和本課的電腦可以用 check.py 比 md5(上一段)。輸出在 out/blackjack/logs/bj1_md5.txt。
再把切出來的細胞數與連結數對回作者的說法。下表三欄:README 寫的數字;作者執行程式後存進 repo 的紀錄檔 data/mb_manifest.json(程式切完會把細胞數與連結數記在這裡);本機切出來的。
| 項目 | README | 作者 repo 裡的 data/mb_manifest.json | 本機 |
|---|---|---|---|
| 細胞數 PN/KC/MBON/DAN | 682/1,200/97/332 | 682/1,200/97/332 | 682/1,200/97/332 |
| PN→KC 連結 | 22,586 | 7,182 | 7,182 |
| KC→MBON 連結 | 61,210 | 18,183 | 18,183 |
| DAN→MBON 連結 | 3,123 | 3,123 | 3,123 |
| MBON 趨近/迴避 | 56/41 | 56/41 | 56/41 |
表裡的「連結」是兩顆神經元之間有沒有接(算條數),每條連結上有幾個突觸另外記著;模型裡會被學習改動的是第三個量,叫連結強度,而且只有 KC→MBON 這一種連結的強度會被學習改動。連結強度=突觸數換算出的起始值(每顆神經元收到的突觸數縮放成加總為 1)× 增益;增益起始都是 1,只有 KC→MBON 的增益會被學習改動;其他層的突觸數仍然要記,因為訊號要沿著那些固定的連結傳(PART 1 第 4 節)。最後一列:作者把 97 顆 MBON 依主要收到哪一群多巴胺分成兩類,56 顆讓果蠅想靠近、41 顆讓它想躲(歸哪一型看的是每顆 MBON 收到 PPL1 與 PAM 各多少突觸,和兩群各有幾顆無關:16 顆 PPL1 的突觸分給了 56 顆,316 顆 PAM 的突觸絕大部分集中在 41 顆上,PART 1 第 4 節);好惡值(模型對一個輸入算出的分數,正是想靠近、負是想躲,PART 1 第 3 節)的正負就是這樣來的。作者的 manifest 收在 out/upstream/blackjack_mb_manifest_committed.json,本機的在 out/blackjack/logs/bj1_extract_run1.log。
作者留下能比的紀錄(細胞數、連結數)本機全部相同;作者沒附他的 md5,跨電腦的逐位相同要等作者補 md5 才能確認,所以本頁第 2 節表上這一步寫的是「數量相同、本機兩次 md5 相同」。對不上的只有 README 的兩個連結數(下面會查出它們是沒篩選前的數字)。作者的程式先只留「同時接到 PN、又連到 MBON」的 KC(路徑上的 KC,共 3,811 顆),再依每顆「收到 PN 的突觸數加送到 MBON 的突觸數」排名、等距取 1,200 顆(依排名每隔大約三顆取一顆,取到 1,200 顆;PART 1 表裡的 1,200 就是這樣來的)。本課先猜 README 寫的是不取樣、用路徑上全部 3,811 顆時的數字,就用這 3,811 顆切了一次(PART 4 的 X3,換一批 KC 重做 21 點的那項檢查,順便存下的):22,581 條 PN→KC、57,823 條 KC→MBON,PN→KC 只差 5 條,KC→MBON 卻差了三千多條(57,823 對 61,210),這個猜測不成立。再往前一步,連「路徑上」這道篩也拿掉、用資料裡全部 4,064 顆 KC 數連結:22,586 條 PN→KC、61,210 條 KC→MBON,和 README 逐位吻合。多出來的那些 KC 裡,252 顆只送到 MBON、沒收到 PN(所以 KC→MBON 多出三千多條),1 顆只收到 PN(PN→KC 多 5 條)。所以 README 寫的是作者加上篩選與取樣之前的數字,紀錄檔寫的是實際切出來的檔案;兩者都對,量的是不同的東西,README 沒說明而已。(數法由課程倉庫的 scripts/readme_kc_counts.py 算出,在 out/blackjack/readme_kc_counts.json。)它們不影響任何實驗結果——實驗讀的是 mb_circuit.npz,不讀 README 的這兩個數;這個檔案在本機兩次逐位相同,和作者的檔是否逐位相同無從確認(作者沒附 md5),但細胞數與連結數和作者的紀錄檔相同。
  ok  synapses              121,933,227
  ok  kenyon_cells                4,064
  ok  mbons                          97
  ok  pam                           316
  ok  ppl1                           16
  ok  projection_neurons            682
4BJ2 21 點 30,000 手:成績對上
21 點的規則、編碼、學習在 PART 1 第 5 節。模型怎麼打,分三句(先說一個零件:牌面的每個特徵,例如點數、明牌、動作,各由一批固定的投射神經元 PN 代表,PN 再把訊號傳給 KC)。第一,每一手把牌面(自己的點數、手裡的 A 算不算 11 點,也就是軟手、莊家翻開的那張明牌)和一個候選動作,再加上「這是不是這手的第一個決定」(只拿兩張牌時;加倍只有這時能選),合起來算成一種「氣味」:同一手牌配「要牌」(再拿一張)、「停牌」(不拿了)、「加倍」(加一注、只再拿一張)是三種不同的氣味。第二,每種氣味點亮一組 KC(活化:哪些 KC 被點亮),模型對它算出一個好惡值,三個動作裡選好惡值最高的。第三,一手結束,贏了給獎賞多巴胺、輸了給懲罰多巴胺,這一手做過的每個決定都依 PART 1 第 4 節的學習規則更新連結。作者在 flybrain/mb/blackjack.py 的檔尾用註解寫了實驗設定:3 個種子、每個 30,000 手。四個條件:未訓練(不學、不探索)、關掉學習、切斷多巴胺、連結體 + 多巴胺(完整模型),各打 3 個種子;表在下面。勝率在這裡指平均每手的淨輸贏(以一注為單位、寫成百分比:−15% 就是平均每手輸 0.15 注),取最後 2,000 手。表裡列名的「探索」是模型每做一個決定都有一定機率不看好惡值、隨機亂選動作,這個機率從 35% 隨打過的手數逐漸下降、逼近 3%(PART 1 第 5 節)。結論先說:對照組沒有上升;有探索的兩個略往下掉,是亂選變少、往未訓練的水準靠,不是學壞。細節如下。四個條件裡有探索的兩個對照(關掉學習、切斷多巴胺)也照同樣的時程把亂選比例降下來,但它們的曲線沒有往上走:三個種子平均從第一個 2,000 手的 −42.7% 掉到最後的 −47.5%,掉了約 5 個百分點。掉的方向說得通(「爆牌」:點數超過 21,直接輸):亂選(−44.5%)其實比照沒學過的好惡值選(未訓練那組的 −48.0%)略好一點(未訓練的蕈狀體幾乎每格都要牌,常爆牌,本頁第 5 節),亂選變少,成績就往下靠向未訓練的水準。但三個種子算不準幅度。先說結論:照 20 個種子看,這兩個對照組只掉約 2 個百分點,和「亂選變少」的估計相符;三個種子掉 5 個百分點,主要是種子 0 頭 2,000 手特別好(−39.3%)把起點拉高了,種子 0 為什麼特別好本課沒查。細節:對照組三個種子頭 2,000 手的 −42.7% 比純亂選和純未訓練都好,兩個混不出這個數。本課把未訓練的蕈狀體固定 28.6%(頭 2,000 手的平均亂選機率)逐個決定亂選、各打 20,000 手,三個種子平均 −46.1%,正好落在兩者之間;−42.7% 比 −46.1% 好 3.4 個百分點,這個差距比三個種子的平均該有的浮動大(標準差:各種子離平均的典型距離;PART 4 跑的 20 個種子裡,切斷多巴胺頭 2,000 手的標準差是 2.1 個百分點,三個種子的平均只會浮動約 2.1 ÷ √3 ≈ 1.2),所以不是平均的正常浮動,而是種子 0 這一個特別偏:它比 20 個種子的平均好了將近三個標準差。20 個種子裡,切斷多巴胺頭 2,000 手平均 −45.4%,到最後 2,000 手的 −47.2% 只掉約 2 個百分點,和 −46.1% 的混合估計一致。所以「不動」指的是沒有上升、沒有離開「什麼都沒學」那一帶;而有多巴胺那組從頭 2,000 手的 −25% 上下升到末 2,000 手的 −14.8%,往上走了 10 個百分點,方向相反,這個上升不可能是亂選變少造成的。
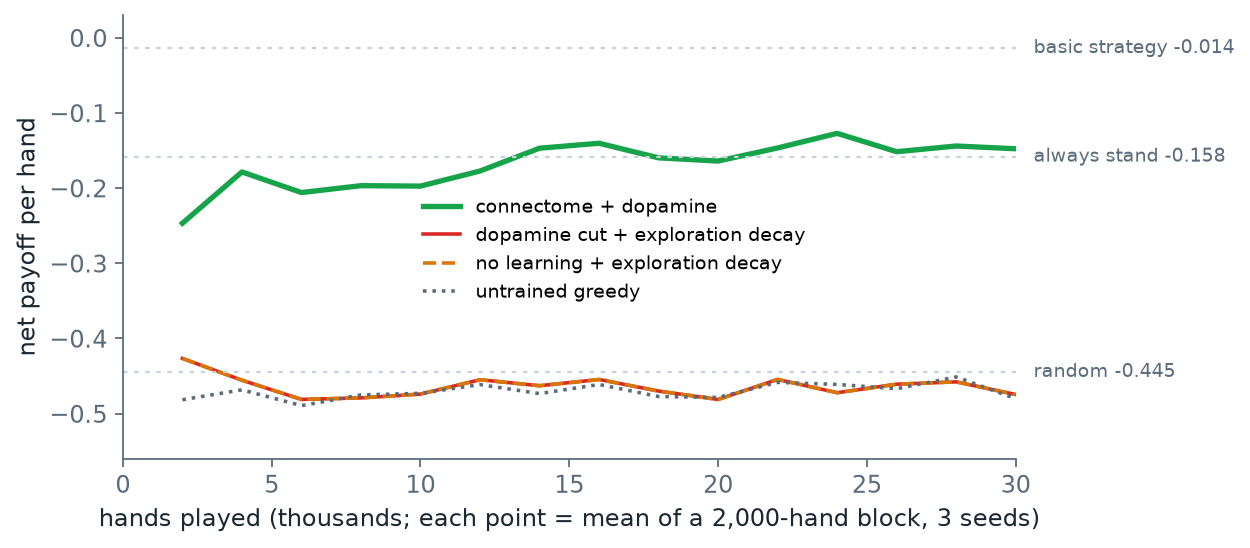
scripts/make_figures.py 從 out/blackjack/bj2_blackjack_30000.json 畫出。| 條件 | 作者的勝率(開始 → 最後 2,000 手) | 本機(3 種子) | 平均 |
|---|---|---|---|
| 未訓練 | −45% | −44.8%/−46.9%/−52.3% | −48.0% |
| 關掉學習(探索照常遞減) | −45% → −45% | −43.9%/−47.0%/−51.5% | −47.5% |
| 切斷多巴胺(探索照常遞減) | −46% → −47% | −43.9%/−47.0%/−51.5% | −47.5% |
| 連結體 + 多巴胺 | −45% → −16% | −15.0%/−16.4%/−12.9% | −14.8% |
上表本機欄只列最後 2,000 手;本機的「開始」值在本節末的終端機輸出(winrate 箭頭前面那個數)。兩個「開始」量的不是同一個時間點:作者沒寫他的 −45% 和 −16% 各取哪一段手數;−45% 和未訓練那列相同,本課推測是還沒學之前的水準;本機的「開始」是打完頭 2,000 手的平均,而學習從第 1 手就開始,這 2,000 手已經在學,所以是 −25% 上下。本課不拿兩個「開始」互比,判定比的是最後的水準與形狀。作者的值出自 blackjack.py 檔尾註解(收在 out/upstream/blackjack_py_RESULT_comment.txt);本機在 out/blackjack/bj2_blackjack_30000.json;固定 28.6% 亂選的未訓練與 20 個種子頭 2,000 手的統計在 out/blackjack/part3_extras.json(scripts/part3_extras.py)。「關掉學習」與「切斷多巴胺」三個種子的數字一模一樣:多巴胺送不到 MBON 時連結一樣不會變,而多巴胺在這個模型裡只用來改連結強度、不參與算好惡值,所以兩種對照對模型的效果相同,又用同一串亂數抽牌與抽探索,打出來的每一手都一樣。作者這兩列卻不一樣(−45% → −45% 對 −46% → −47%),照本機用的程式它們該一模一樣;兩個條件若真的相同,原始數字就相同,取整後也一定相同,所以這個差異不是取整造成的。最可能的解釋是作者跑出這兩列的程式和公開的版本不同(本頁第 5 節把它列為證據之一);但也可能是作者整理表格時手抄寫錯,或兩列用了不同的種子、不同的設定,本課分辨不出來,差在哪也沒追;兩列都列出來是照作者的表。本機未訓練與對照組的三個種子彼此差到約 7.5 個百分點(完整模型差 3.5),表示單一種子的勝率本來就有這麼大的浮動,所以這一步比的是三種子平均與形狀,不是逐位。
勝率的改善重現了,而且只出現在有多巴胺的那一組。不過圖 2 也看得出,學會的那條只爬到「永遠停牌」參考線附近——成績和一個永遠不要牌的玩家差不多,離照基本策略打的 −1.4% 還差約 13 個百分點。基本策略是最好的打法,照著打也還是小輸,因為 21 點的規則讓莊家佔優勢(例如玩家先爆牌就輸,莊家之後爆也不算),長期平均 −1.4% 已經是上限附近。
untrained greedy                   seed 0  winrate -0.447 -> -0.448  agree 0.450 -> 0.450  ...
no learning + exploration decay    seed 0  winrate -0.393 -> -0.439  agree 0.450 -> 0.450  ...
dopamine cut + exploration decay   seed 0  winrate -0.393 -> -0.439  agree 0.450 -> 0.450  ...
connectome + dopamine              seed 0  winrate -0.259 -> -0.150  agree 0.412 -> 0.438  ...
connectome + dopamine              seed 1  winrate -0.244 -> -0.164  agree 0.392 -> 0.446  ...
connectome + dopamine              seed 2  winrate -0.238 -> -0.129  agree 0.465 -> 0.473  ...
reference {'basic strategy': -0.013925, 'random': -0.44475, 'always stand': -0.15835}
5BJ3 作者附的大腦檔:重現不出來,學到的策略每個種子都不同
成績只到永遠停牌的水準,光看成績分不出它學到的是什麼打法,所以要看它每一格選什麼。作者宣稱的「它學到什麼策略」就是這個:看模型在基本策略表的 260 格裡每一格選的動作有幾格與表相同,就是一致率(表的定義見 PART 1 第 5 節)。作者還附了一個訓練完的蕈狀體狀態檔 data/brain_seed.json(下面叫它大腦檔)。這一部分,作者自己留下的三份資料就互相矛盾:
| 來源 | 與基本策略一致 | 260 格裡的選擇 |
|---|---|---|
| README | 52% | 幾乎都停牌,只在 10、11 點要牌(照這句填 260 格只對中 109 格,41.9%,不是 52%;PART 1 第 5 節) |
blackjack.py 檔尾註解 | 48.1% | 停牌約 227 格、加倍 0 格 |
作者附的大腦檔 data/brain_seed.json(檔內記錄,由作者網頁版的 JavaScript 評分程式算出;檔內標明來自「Python 30,000 手、種子 0」) | 53.1% | — |
| 同一個大腦檔,載入作者的 Python 模型重新評分 | 51.9% | 要牌 97、停牌 149、加倍 14 |
| 本機重跑(同樣用種子 0) | 43.8% | 要牌 6、停牌 214、加倍 40 |
表裡作者大腦檔的兩個值,這是比對 (a):同一個大腦檔,檔內記錄 53.1%(138 格)是作者網頁版自己算的,載入 Python 重算是 51.9%(135 格),兩套評分程式對同一份連結強度算出的格數差 3 格(評分沒有隨機性,所以差異一定來自兩套程式的算法或數值精度不同,例如兩個動作好惡值幾乎相同時怎麼取捨),事先訂的是逐位相同,所以這一比對不上,原因本課沒有追;51.9% 取整後碰巧等於 README 的 52%,不能拿來當對上的證據。這 3 格比下面大腦檔和本機種子 0 差的 114 格小得多,不影響這一節的結論;表裡和下面的「要牌 97 格」都是 Python 重算的結果。
比對 (b):52% 高於本機三個種子(最高 47.31%),但 README 沒寫 52% 是一次訓練還是幾次的平均。若是一次訓練,該比的是單一種子會落在哪:PART 4 跑的 20 個種子,單一種子學完的一致率從 40.8% 到 59.2%,有 2 個在 52% 以上(55.0%、59.2%),所以 52% 單一次跑得出來。若是平均,20 個種子平均的 95% 信賴區間(46.1% 到 49.7%;信賴區間:只跑了 20 個種子,算出的平均帶著誤差,這個範圍約 95% 會包含跑無限多個種子的平均)不含 52%。本機三個種子的平均 45.3% 也在這個區間外:區間估的是 20 個種子的平均,只取 3 個種子平均起來晃得更多,種子 0 到 2 碰巧都偏低。所以 (b) 這一項本身說明不了多少(本頁第 1 節說過,它是事先訂錯的標準)。
再看大腦檔選了哪些動作。它要牌 97 格,既不是 README 說的「幾乎都停牌」,也不是程式註解說的「停牌約 227 格」。這是不是表示作者公開的程式學不出這種表?不是。本課把 PART 4 的 20 個種子重打一次、存下逐格表:學完的要牌從 6 格到 111 格都有(停牌 141 到 231 格、加倍 8 到 53 格),97 格在這個範圍內,種子 16 甚至要牌 111 格。每個種子學到的表本來就差很多,所以「本機某個種子和大腦檔差 114 格」單獨看並不意外。真正對不上的是大腦檔自己標明的種子:它寫著種子 0,而公開程式用種子 0 跑,學完只要牌 6 格(20 個裡最少的),兩張表差 114 格(和種子 0 選對基本策略的 114 格碰巧同數,是兩個不同的量)。同一份程式、同一個種子在本機重跑是逐位相同的(PART 4 的種子 0 和 BJ2 的種子 0 一模一樣),所以如果大腦檔真出自這份公開程式的種子 0,應該得到同一張表。這一條本身有兩種解釋:作者用的程式版本不同,或作者的執行環境(套件版本、作業系統)不同,單憑它分不出來。另一條證據只指向程式:本頁第 4 節作者表格裡兩個對照列不一樣,而這兩個條件在公開程式裡走的是完全相同的計算,不管在什麼環境都必定相同。兩條合起來,最直接的解釋是作者的大腦檔與表格出自另一個版本或另一組設定的程式,但作者沒有記錄,本課無法確認。
勝率能重現、每張表卻各不相同,並不矛盾:本課把作者的大腦檔拿來實打 20,000 手(不學、不探索),成績 −13.5%(95% 信賴區間 −14.9% 到 −12.1%;信賴區間:照這個方法算的範圍,約 95% 會包含真正的平均,這裡用來表示 −13.5% 本身帶著約 ±1.4 個百分點的誤差)。本機種子 0 學完之後,用同樣條件(不學、不探索、發牌種子 0)也打 20,000 手,成績 −14.3%(95% 信賴區間 −16.0% 到 −12.6%),兩個區間重疊,表示以 20,000 手的精度分不出兩者的成績(區間寬度不同,是因為兩張表加倍的格數不同(大腦檔 14 格、本機種子 0 是 40 格),加倍一手輸贏兩注,每手輸贏的起伏比較大;「重疊」只是粗略的判斷,嚴格比要算兩者差距的區間);表裡的 −15.0% 是訓練中的最後 2,000 手,還有約 3% 亂選,條件不同,不拿來直接比。20 個種子要牌從 6 到 111 格,最後 2,000 手的勝率都在 −17.8% 到 −5.0% 之間(最好的 −5.0% 是種子 15;單一個 2,000 手區塊本身約有 ±5 個百分點的誤差(這是 95% 範圍,約兩倍標準差;和第 4 節 20 個種子之間頭 2,000 手的標準差 2.1 個百分點是同一個量級),所以這個範圍有一部分是發牌運氣;「停在永遠停牌附近」說的是 20 個種子的平均 −13.2%),要牌格數和勝率看不出關係:很多張不同的 260 格表都能打出差不多的勝率,勝率對上不代表每一格的選擇相同。(大腦檔還有第三處對不上:檔內記錄的勝率是 −17.86%,和實打的 −13.5% 不同,原因同樣沒追;它沒有列進事先訂的比對 (a)(b),因為事先只訂了一致率,這裡照實補記。)
所以這一步的結論要分開講:「有多巴胺才會變好」可以重現;作者附的大腦檔重現不出來(它標明的種子 0,在公開程式裡學出的是另一張表);而「學到什麼策略」本身就不是一個固定的答案,每個種子學到的表差很多,共同的只有「以停牌為主」。同一個理由也適用於 BJ2:固定種子只保證同一份程式在同一個環境能重做,作者跑的版本與環境本課不知道,所以本機與作者的差異來源沒追。PART 5 把種子 0 這 30,000 手錄成影片,可以親眼看它從「幾乎每格都要牌」變成「幾乎每格都停牌」;種子 0 是 20 個種子裡要牌最少、最接近永遠停牌的一個,不是典型。
大腦檔的評分由 blackjack/scripts/bj3_author_brain.py 算出(out/blackjack/bj3_author_brain.json);大腦檔實打 20,000 手、和本機種子 0 逐格比對,由課程倉庫的 scripts/part3_extras.py 算出(out/blackjack/part3_extras.json);本機三個種子的平均一致率是 45.3%。附帶發現(也是 (b) 對不上說明不了多少的原因):一致率分不出學沒學。沒學過的蕈狀體一致率就已經 45%,因為它幾乎每格要牌(起始好惡值由兩件事決定:作者用固定的亂數把 PN 分給牌面的五個特徵(點數、明牌、動作、軟硬、是不是前兩張),以及作者挑的那 1,200 顆 KC 怎麼接;兩者都和打牌種子無關。「要牌」那組剛好在幾乎每格都最高,PART 1 第 5 節),剛好對中表上該要牌的那些格(未訓練要牌 239 格、停牌 17 格、加倍 4 格;要牌對中 106 格,另外 17 格停牌裡有 11 格剛好對中,加倍 4 格都沒對中,共 117 格,45%)。學完三個種子平均仍是 45.3%(43.85%、44.62%、47.31% 的平均;終端機輸出只印到小數第三位,0.438、0.446、0.473 直接平均會得 45.2%)。策略從幾乎全要牌翻成幾乎全停牌、成績從未訓練的 −48.0% 升到學完的 −14.8%(30 多個百分點)、一致率卻不動,三件事能同時成立,是因為基本策略表裡該要牌 115 格、該停牌 106 格、該加倍 39 格:全要牌對中前者、全停牌對中後者,各四成多。所以 45% 到 53% 之間的差異能不能代表「學到策略」,本身就存疑。補充 agree 怎麼算:本頁第 4 節末的終端機輸出裡完整模型三個種子的 agree 從 0.41、0.39、0.47 變成 0.44、0.45、0.47。它的算法和 BJ3 的評分相同,拿當時的連結去算 260 格各選什麼,不含亂選、算的時候不學習;第一個值是打完 2,000 手才算的,那時連結已經學了 2,000 手,表已經不是沒學過的那張,所以起點不等於未訓練的 45%(種子 0、1 比它低,種子 2 比它高)。比較基準是「未訓練 45%」對「學完 45.3%」,不是每行自己的起點。