1結論:四項檢查
先說這一頁在做什麼。PART 3 照作者的設定重跑了 21 點:一個從果蠅腦連結體(整顆腦裡哪顆神經元連到哪顆、各有幾個突觸的清單;突觸是兩顆神經元之間傳訊號的接點,愈多連得愈強)切出來的蕈狀體(果蠅腦裡負責學氣味好壞的那一區)模型(PART 1),打 30,000 手 21 點,有多巴胺的那組成績會進步,沒有的不會。重現對上,只證明「照作者的做法會得到作者的數字」;它沒有回答的是:這個結論靠什麼撐著?換一副牌、換一批神經元、把接線打亂,結論還站不站得住?這一頁做四項作者沒做的檢查來回答。每一項都不改作者的學習規則,也不改他的程式檔;X2、X3 要改接線或換一批神經元,是本課另寫的程式在載入模型之後動手(作者沒寫打亂 DAN→MBON 的程式,本課寫),X1 只加種子,X4 只看標記;程式在下載包的 blackjack/scripts/bj_extra.py(PART 6 第 4 節逐行讀它),結果另存,不覆蓋重現的輸出。代號 X1–X4 是本課自己編的。每一節照同一個順序寫:作者原本怎麼說、我們懷疑哪裡不夠、怎麼檢、事先訂下怎樣算過、結果、結論能說到哪裡為止。
本頁反覆用到的詞,先一條一條定義。
- 成績:平均每手的淨輸贏,以一注為單位寫成百分比(−15% 就是平均每手輸 0.15 注),一律取 30,000 手裡的最後 2,000 手,與 PART 3 相同。
- 要牌/停牌/加倍:21 點裡每一手的決定。要牌是再抽一張;停牌是不抽,就用手上的點數和莊家比;前兩張時還可以加倍(加一注、只再抽一張)。點數超過 21 就爆牌輸。
- 永遠停牌:每手都不抽牌的固定打法,成績 −15.8%(用模擬 20,000 手估出的;這一條用到的「完整模型」「95% 信賴區間」在下面幾條定義);比隨機亂選(−44.5%)好、比照基本策略(數學上最佳的打法表,下面「一致率」那條)打的 −1.4% 差很多。完整模型學完的成績略好於這條線(20 個種子 −13.2%,好約 2.7 個百分點,是用沒四捨五入的兩個平均相減,四捨五入後相減看起來是 2.6;−15.8% 本身是模擬 20,000 手的結果,也帶著誤差,兩邊合起來差距的 95% 信賴區間是 0.7 到 4.6 個百分點,不含 0;
out/blackjack/reference_margin.json),但離 −1.4% 很遠;本頁說「永遠停牌附近」「永遠停牌上下」指的就是這個範圍(PART 3 第 4 節)。 - PN、KC、MBON、DAN:蕈狀體模型裡的四群神經元,訊號照 PN → KC → MBON 走。PN(投射神經元)把「牌面配一個候選動作」當成一種氣味送進蕈狀體,同一個牌面配要牌、停牌、加倍是三種不同的氣味;KC(Kenyon 細胞)把每種氣味編成一組活化;MBON(輸出神經元)每顆帶一個固定標記,+1 趨近或 −1 迴避;DAN(多巴胺神經元)把獎賞或懲罰送進來,分懲罰群 PPL1 與獎賞群 PAM。「A→B」指 A 連到 B 的那一層連結,連結的多寡是連結體量到的突觸數。
- 好惡值:某個牌面配某個動作(也就是某一種氣味),各 MBON 的活動乘上它的標記再加總;同一個牌面的三個動作各算一個,模型選好惡值最高的動作。
- 牌面:自己手上的點數(硬手 5 到 21、軟手 13 到 21,共 26 種;手裡有 A 而且 A 算 11 點叫軟手)配莊家(發牌、和你比點數的那一方)翻開的那張明牌(10 種)。26 × 10 = 260 種牌面,就是基本策略表的 260 格。本課的規則不能分牌(一對牌拆成兩手分開打),所以表裡沒有分牌這個動作;硬 4(一對 2)與軟 12(一對 A)打牌時會遇到,模型照樣打、照樣學,只是作者的表從硬 5、軟 13 起算,不拿它們評分。
- 一致率:模型在基本策略表(賭場數學算出來的「每種牌面該怎麼打」,260 格,PART 1 第 5 節)裡選對幾格的比例。一致率看的是不含探索的那張表(每格選好惡值最高的動作),不是實際打出來的決定。基本策略 260 格裡該要牌 115 格、該停牌 106 格、該加倍 39 格。作者選的那 1,200 顆 KC 沒學過時一致率就有 45%(換一批 KC 起點就不同,見 X3),因為它幾乎每格都要牌,剛好對中表上該要牌的那些格(PART 3 第 5 節)。
- 種子:給電腦亂數產生器的起點,決定洗牌順序與模型什麼時候亂選;換一個種子就是換一副牌序重打一次。
- 標記怎麼來的:作者看每顆 MBON 的多巴胺輸入主要來自懲罰群還是獎賞群,主要來自懲罰群的標 +1 趨近、主要來自獎賞群的標 −1 迴避;是多數決,所以後面會說「幾乎都」而不是全部。為什麼被懲罰管的反而叫趨近,第 3 節會走一遍。
- 完整模型:作者表格裡的「連結體 + 多巴胺」,什麼都沒拿掉的那組。
- 95% 信賴區間:只跑了幾個種子,算出的平均帶著誤差;這個區間是照固定方法估出的範圍,約 95% 會包含「跑無限多個種子的平均」。兩組的區間不重疊,表示差異不太可能只是哪幾副牌的運氣。算法在第 2 節。
- 大腦檔:作者訓練完存下來、附在他公開的程式資料夾(repo)裡的模型連結狀態檔,載入後可以直接打牌或評分(PART 3 第 5 節)。
- 探索:模型每做一個決定都有一定機率不看好惡值、隨機亂選;隨著打過的手數增加,這個機率從 35% 逐漸降到接近 3%。量成績的最後 2,000 手仍有約 3% 的決定是亂選的,完整模型和切斷多巴胺都一樣;未訓練不探索,是 0%。
- 兩個對照組:切斷多巴胺(多巴胺送不到蕈狀體,所以學不到任何東西,但照樣有探索)與未訓練(不學、也不探索)。留兩個,是為了把「探索本身會不會改變成績」和「學習會不會」分開看。
最後說明本頁問的是什麼:學完的模型多數格都選停牌,所以成績接近永遠停牌;本頁問的「有沒有學」,對作者那批 KC 大致就是有沒有從「幾乎每格都要牌」學到「少要牌」;換一批 KC 時沒學過的起點不一定是全要牌(X3 的隨機二沒學過就有 193 格停牌),所以 X3 一律和各自的未訓練起點比。本頁不再追它學到什麼打法(那是 PART 3 第 5 節與 PART 5 的事),只問有沒有學、靠什麼學,用成績有沒有離開對照組來判。
| 代號 | 問的問題 | 結果 | 對作者的結論有什麼影響 |
|---|---|---|---|
| X1 | 3 個種子的進步,會不會只是這 3 副牌的運氣 | 20 個種子:完整模型 −13.2%,切斷多巴胺 −47.2%,未訓練 −47.3%;兩邊的 95% 信賴區間完全分開 | 支持:「有多巴胺才會變好」不是運氣 |
| X2 | 打亂哪一層接線,21 點才學不會 | 打亂 KC→MBON:學完 −15.6%,仍在永遠停牌附近(5 種裡 3 種從 −65% 以下學上來,2 種沒學就在那裡);打亂 DAN→MBON:−48.8%,和未訓練差不多,一致率 15 次全部掉到 37% 以下(平均 33%) | 部分支持:DAN→MBON 接線換掉、標記留著,21 點就學不會或只學到一點(5 種重排裡兩種比未訓練好約 7 到 9 個百分點,一種成績掉到 −65%,學反);作者說的「接線本身重要」還沒和標記分開驗 |
| X3 | 換一批 KC,結果會不會變 | 全部 3,811 顆與三組隨機 1,200 顆,成績都在 −15.8% 到 −12.3% 之間 | 支持:結果不是作者挑的那 1,200 顆的特性 |
| X4 | MBON 的趨近/迴避標記與文獻規則一致嗎 | 97 顆中 62 顆一致;標記和文獻毫無關係、只保留 56/41 的比例時,碰巧也會一致約 52 顆 | 標記只部分對得上文獻;推論不影響 21 點的結果(沒有實測);但標記不能拿來談生物學 |
每一列的數字出處見下面對應的小節;主要出自 out/blackjack/bj_extra.json(X1 到 X4 各一個段落:X1_seeds20、X2_layers、X3_kc_subsets、X4_mbon_valence);補跑的未訓練起點、X4 的碰巧期望與重排檢定(把標記隨機重新分配很多次,看碰巧能有多少顆一致)、X2 的對齊比例等另有出處,見各節註明的檔案。
2X1 3 個種子夠嗎:加到 20 個
作者的說法:完整模型 3 個種子打 30,000 手,成績從 −45% 進步到 −16%(作者寫在程式註解裡的數;作者沒寫這兩個數各取哪一段手數,−45% 和他程式註解表格裡未訓練那列相同;作者的未訓練 −45% 和本課重跑 3 個種子的 −48.0% 差 3 個百分點,原因本課沒追,PART 3 第 4 節);PART 3 用同樣 3 個種子重跑得到 −14.8%,本頁拿後者比;兩個對照組不動(PART 3 第 4 節)。懷疑:PART 3 已經看到單一種子的成績彼此可以差到 7 個百分點(未訓練那組 3 個種子是 −44.8%、−46.9%、−52.3%;完整模型那 3 個種子是 −15.0%、−16.4%、−12.9%,最多差約 3.5 個百分點)。3 副牌很少;如果再換 3 副,「進步」會不會變小、甚至消失?另外作者的 3 個種子是 0、1、2,是他選的,會不會剛好挑到學得好的?檢法:三個條件各改用 20 個種子(0 到 19,前 3 個就是作者的 3 個),每個 30,000 手,其他設定全部照舊。怎樣算過:事先訂兩條。第一,完整模型 20 個種子的 95% 信賴區間要和兩個對照組的完全分開,才算「有多巴胺才會變好」站得住;第二,作者那 3 個種子的平均不能比 20 個種子的平均更好(成績更高),更好才是挑過的跡象。這一條只看方向、沒有訂容許範圍:0、1、2 看起來像預設值,但作者沒有記錄是不是先試過別的種子,所以仍值得看一眼。95% 信賴區間怎麼算:20 個種子的平均 ± 1.96 × 標準差 ÷ √20(標準差:各種子的成績離平均有多散的典型距離);意思是:照這個方法算出來的區間,約 95% 會包含真正的平均成績(種子無限多時的平均)。它說的是「平均值有多準」,不是「單一個種子會落在哪」。1.96 是種子很多時用的係數;種子少時嚴格的做法要換成 t 分布的係數(20 個種子是 2.09,5 個是 2.78,3 個是 4.30),區間會更寬:種子少的時候,連「每個種子差多少」(標準差)本身都估不準,所以要用較大的係數把區間放寬,這組放寬後的係數就叫 t 分布係數。本頁的區間照 bj_extra.py 一律用 1.96,所以種子少的那幾組(X2 的 5 個、X3 的 3 個)偏窄,要當近似看;改用 t 分布的區間寫在各節表後,四項的判定結果都不因此改變。
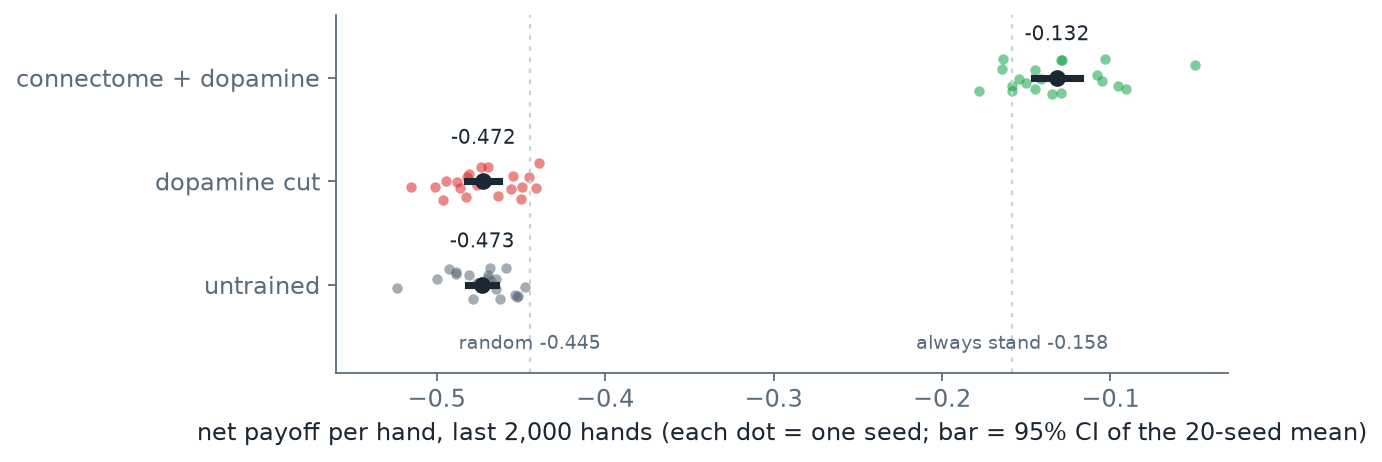
scripts/make_figures.py 從 out/blackjack/bj_extra.json 的 X1_seeds20 畫出。| 條件 | 作者的 3 個種子,本課重跑(PART 3) | 20 個種子的平均 | 95% 信賴區間 | 一致率(20 個種子平均) |
|---|---|---|---|---|
| 完整模型 | −14.8% | −13.2% | −14.5% 到 −11.8% | 47.9%(46.1% 到 49.7%) |
| 切斷多巴胺 | −47.5% | −47.2% | −48.2% 到 −46.3% | 45.0% |
| 未訓練 | −48.0% | −47.3% | −48.1% 到 −46.5% | 45.0% |
由 blackjack/scripts/bj_extra.py 算出,輸出在 out/blackjack/bj_extra.json 的 X1_seeds20(每個條件的 last 是成績、agree_last 是一致率)。切斷多巴胺與未訓練的一致率 20 個種子全部恰好是 45.0%:兩組的 KC→MBON 連結從頭到尾沒變過,260 格表就是沒學過的那一張,與種子無關。
結果:第一條過:完整模型的區間(−14.5% 到 −11.8%)和兩個對照組的區間(都在 −48% 上下)之間隔了三十幾個百分點,完全不重疊;單看圖 1,完整模型最差的一個種子(−17.8%)也比對照組最好的一個種子(−43.9%)好。切斷多巴胺與未訓練只差 0.1 個百分點:沒有學習時,早期 35% 的亂選留不下任何東西(連結沒變),最後 2,000 手那約 3% 的亂選也幾乎不改變成績,所以完整模型和對照組的差距來自學習。這個比較量不到「有學習時,早期的探索幫了多少」,那是另一個問題(PART 5 第 3 節粗估過)。第二條也過:作者 3 個種子的平均 −14.8% 比 20 個的平均 −13.2% 略差,不是挑過的方向。結論:「有多巴胺才會變好」不是這 3 副牌的運氣。順便看到兩件事。第一,作者在 README(程式附的說明文件)寫完整模型與基本策略一致 52%;PART 3 用 3 個種子重跑是 45.3%,本頁 20 個種子是 47.9%,沒對上。但 README 沒寫 52% 是一次訓練還是平均:若是平均,20 個種子的區間 46.1% 到 49.7% 不含它;若是一次訓練,20 個種子裡有 2 個在 52% 以上(55.0%、59.2%),單一次跑得出來。所以這一項對不上說明不了多少,原因本課沒有追到(PART 3 第 5 節)。第二,一致率量不出有沒有學到策略:完整模型學完 47.9%,比沒學過的 45.0% 只高 2.9 個百分點,成績卻進步了三十幾個百分點;而且這 2.9 個百分點全部來自硬 21、軟 21 兩列(20 格;兩張牌最多硬 20,兩張就湊成軟 21 是黑傑克、直接結算,所以這兩列不會是第一個決定;但要牌補到 21 點後程式會再問一次,每個種子 30,000 手裡有 186 到 1,050 次,那時要牌常常輸(硬 21 再要必爆),模型學到停牌,評分格只差「是不是前兩張」一項,跟著翻成停牌:未訓練 20 格裡停牌 6 格,學完 17 到 20 格;基本策略這兩列全是停牌(硬 21、軟 21 兩列 20 格要牌後才會遇到的次數、評分格各選什麼,由課程倉庫的 scripts/row21_visits.py 算出,在 out/blackjack/row21_visits.json)),扣掉這 20 格,學完 20 個種子平均 44.4%(95% 信賴區間 42.3% 到 46.4%),和沒學過的 46.25% 分不出差別(PART 1 第 5 節;本課後來把 20 個種子重打、存下逐格表,out/blackjack/seeds20_tables.json)。那成績進步的三十幾個百分點從哪來:學習把很多格從要牌改成停牌,有些格因此從對變錯、有些從錯變對,對錯格數差不多抵消,但各格選錯的代價差很多:本課推測,主要是不再在高點數時要牌爆掉,輸的錢就少了很多(PART 5 第 3 節)。成績和一致率量的不是同一件事,很多張不同的 260 格表都能打出「永遠停牌」上下的成績:PART 3 第 5 節把作者附的大腦檔(要牌 97 格)拿來實打,−13.5%,和本課種子 0(要牌 6 格)學完後同條件(不學、不探索)實打的 −14.3% 差不多,兩張表卻有 114 格不同。用 t 分布的係數 2.09,完整模型的區間是 −14.6% 到 −11.7%,仍和對照組完全分開。
3X2 打亂哪一層接線,21 點才學不會
蕈狀體裡有兩層接線跟學習有關(PART 1 第 4 節)。KC→MBON:Kenyon 細胞(把每種「氣味」,在 21 點裡是每種牌面配動作,編成一組活化的那群神經元,簡寫 KC)連到輸出神經元(MBON)的連結,學習時被多巴胺削弱的就是這一層。DAN→MBON:多巴胺神經元(DAN)連到哪些 MBON,決定獎賞與懲罰的訊號送到誰,整場固定不變。作者的說法:作者在氣味制約實驗(讓同一個蕈狀體模型學「某種氣味配電擊、另一種不配」,是作者的主實驗,21 點是後來加的;本課不重現,PART 1 第 7 節簡介)裡做過一個對照:把 KC→MBON 打亂,學習幾乎不受影響。他的解讀是:KC 連到哪顆 MBON 不重要,重要的是懲罰與獎賞的訊號能送到哪些 MBON,也就是 DAN→MBON 這一層。懷疑:這是推論。作者沒有直接打亂 DAN→MBON 來驗;而且兩層在 21 點上都沒試過,21 點的學習參數和制約那組不同:被削弱的連結會慢慢回到原值(回復),21 點裡這個回復慢 240 倍(PART 1 第 4 節),學到的東西留得比制約實驗久得多、會一路累積,接線的影響可能比制約實驗裡大,制約上的結果不一定搬得過來。
檢法:兩層各做一項打亂(KC→MBON 做 5 種打亂、各打 1 個種子;DAN→MBON 做 5 種重排、各打 3 個種子),再各打 30,000 手,其他全部照完整模型。打亂 KC→MBON 用作者自己程式裡的打亂法(PART 6 第 6 節:連結的強度全部重新分配、再把 KC 的列隨機調換,每顆 MBON 的夥伴數不變。把 KC→MBON 想成一張表:每一列是一顆 KC 連到各 MBON 的強度;夥伴數是連到某一顆 MBON 的 KC 有幾顆。「重新分配」是把表裡所有不是 0 的強度值洗牌、放回原本有連結的那些格子;「調換列」看起來像替 KC 換名字,其實不是:哪顆 KC 被哪種牌面點亮由 PN→KC 決定,那一層沒動,所以調換列等於把「這個牌面點亮的 KC」接到另一組 MBON 上),5 個種子各一種打亂。打亂 DAN→MBON 作者沒寫,本課寫:把「每顆 DAN 連到哪顆 MBON」這張表的 MBON 欄位隨機重排,每顆 DAN 送出的量不變、每顆 MBON 收到的量換成另一顆原本收到的;MBON 的趨近/迴避標記不動。做 5 種重排、每種 3 個種子,共 15 次。兩層次數不同的原因:打亂 KC→MBON 用作者的程式,打亂的方式和牌序由同一個種子決定,一個種子就是一種打亂配一副牌,分不開;打亂 DAN→MBON 是本課自己寫的,重排和牌序分開控制,每種重排配 3 副牌,才看得出同一種重排換牌會差多少。怎樣算過:如果作者的解讀對,打亂 KC→MBON 的成績應該仍在完整模型的水準(X1 的 −13.2% 上下),打亂 DAN→MBON 的應該掉到對照組的水準(−47% 上下)。這裡的「上下」事先沒有訂數字範圍,是本節的一個限制。
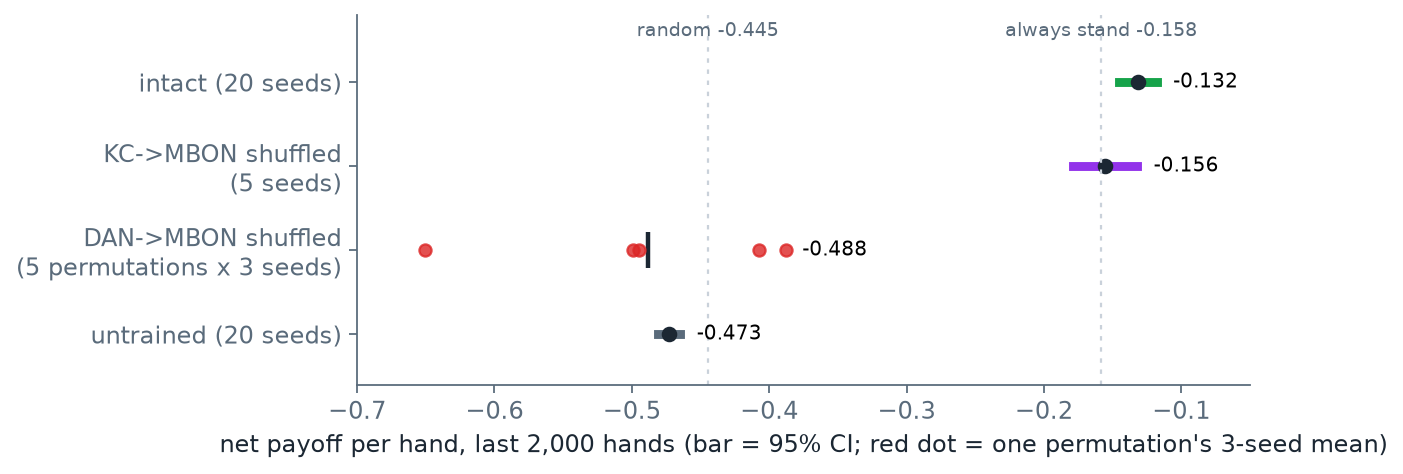
scripts/make_figures.py 從 out/blackjack/bj_extra.json 的 X1_seeds20 與 X2_layers 畫出。| 接線 | 打亂幾次 | 成績 | 95% 信賴區間 | 一致率 |
|---|---|---|---|---|
| 完整模型(沒打亂,X1) | 20 個種子 | −13.2% | −14.5% 到 −11.8% | 47.9% |
| 打亂 KC→MBON | 5 種 × 1 個種子 | −15.6% | −17.9% 到 −13.2% | 43.4% |
| 打亂 DAN→MBON | 5 種 × 3 個種子 | −48.8% | 5 種各自的平均:−38.8%、−49.5%、−40.7%、−65.0%、−49.9% | 33.1% |
| 未訓練(X1) | 20 個種子 | −47.3% | −48.1% 到 −46.5% | 45.0% |
輸出在 out/blackjack/bj_extra.json 的 X2_layers(kc_mbon_shuffled 與 dan_mbon_shuffled;後者每一種重排一個 per_permutation 段落,mean_of_means 是 5 種的平均)。打亂 DAN→MBON 那列不給一個總的信賴區間,因為 5 種重排彼此差太多(從 −38.8% 到 −65.0%),平均一個區間會把這件事藏起來。打亂 KC→MBON 的 5 種各自的未訓練成績與一致率在 out/blackjack/part4_extras.json 的 untrained_kc_shuffled(scripts/part4_extras.py)。
結果:兩條都大致照預期,但第二條要講清楚。打亂 KC→MBON 之後,學完仍在「永遠停牌」那條線附近:5 個種子的成績 −19.5%、−14.6%、−12.6%、−14.2%、−16.9%,平均 −15.6%,區間與完整模型的重疊。但 KC 的連法變了,沒學過時的起點也跟著變,要和自己的未訓練比(和 X3 同一個道理)。本課補跑了這 5 種打亂各自的未訓練(不學、不探索,同樣種子、30,000 手):成績 −18.7%、−81.4%、−87.0%、−65.8%、−16.9%(平均 −54.0%),一致率平均 36.2%(學完 43.4%)。三種是從 −65% 以下學到永遠停牌附近;另外兩種沒學過就已經在 −18.7% 與 −16.9%,學完沒有進步(−19.5%、−16.9%)。所以準確的說法是:五種學完都停在永遠停牌附近,其中三種是學上來的,兩種本來就在那裡。打亂 DAN→MBON 之後學不會:5 種重排平均 −48.8%,和什麼都沒學的未訓練(−47.3%)差不多。分開看,兩種比未訓練好(−38.8%、−40.7%),兩種差不多(−49.5%、−49.9%),最差一種(−65.0%)差很多;成績上明顯「學反」的只有這一種;比未訓練好的那兩種都在對照組的區間(−48.1% 到 −46.5%)之外、比它好,只是離完整模型很遠;它們是 3 個種子的平均,拿去比 20 個種子的區間只能粗看。一致的證據在一致率:15 次全部從沒學過的 45% 掉到 37% 以下,平均 33%,往基本策略的反方向動。一致率下降本身不一定代表學反:X3 的隨機三學完一致率掉了約 6 個百分點,成績卻從 −53.4% 進步到 −15.8%。這裡當證據的是從同一個起點往下掉多少:打亂 DAN→MBON 不動 KC→MBON,而未訓練不送多巴胺,所以它的未訓練表和 X1 的完全一樣,起點就是 45%,學完掉 8 到 16 個百分點。打亂 KC→MBON 的未訓練起點不同(平均 36.2%,比 37% 還低),但它學完是往上走(到 43.4%),所以不衝突:看的是方向,不是絕對值有沒有低於 37%。另外,一致率分不出「學一點」和「沒學」(X1),但掉到這個程度只出現在打亂 DAN→MBON 的時候:完整模型、各種 KC 選法(X3)、打亂 KC→MBON 學完的一致率共 37 次(X1 的 20 次、X3 另外四種選法各 3 次共 12 次、打亂 KC→MBON 5 次;X3 的作者選法就是 X1 的種子 0–2,沒有重複算),全部在 37.7% 到 59.2% 之間;打亂 DAN→MBON 的 15 次全部在 29.2% 到 36.5%,兩組完全不重疊。37% 這條線是看完結果才畫的,是事後的觀察,不是事先訂的判準。五種重排裡最差的一種三個種子都在 −65% 上下,比隨機亂選(−44.5%)還低了 20 個百分點。
為什麼會學反。這是學習規則的必然後果,不是意外。先把第 1 節的定義接起來:每顆 MBON 帶 +1(趨近)或 −1(迴避)的標記;某牌面配某動作的好惡值=各 MBON 的活動 × 標記加總,好惡值高的動作會被選。PART 1 第 4 節說過,多巴胺只會削弱 KC→MBON 的連結,所以要讓好惡值下降,只能削弱 +1 型 MBON 的輸入;要讓它上升,只能削弱 −1 型的輸入。再接上標記怎麼來的(第 1 節):標記是從這張 DAN→MBON 表數出來的,懲罰群 PPL1 連到的 MBON 幾乎都被標成 +1,獎賞群 PAM 連到的幾乎都是 −1。所以輸了的時候,懲罰多巴胺削弱的是 +1 型 MBON 的輸入,這個牌面配這個動作的好惡值往負走,「輸了就少做」成立。贏了的時候,獎賞多巴胺削弱的是 −1 型的輸入,好惡值往正走,「贏了就多做」成立。方向剛好對,不是巧合,是因為標記本來就照這張表定的。重排之後標記沒動、接線換了,懲罰訊號落到哪些 MBON 就跟標記脫鉤。本課量了這件事:原本的接線裡,一單位懲罰有 97.1% 落在趨近型 MBON、一單位獎賞有 92.8% 落在迴避型 MBON,兩個方向都「對」;5 種重排之後,懲罰落在趨近型的只剩 52.7% 到 61.5%,獎賞落在迴避型的只剩 35.8% 到 47.1%。這兩個範圍就是隨機的水準:97 顆 MBON 裡 56 顆是趨近型、41 顆是迴避型,接線完全隨機換位時,懲罰落在趨近型的期望是 56/97 = 57.7%,獎賞落在迴避型的期望是 41/97 = 42.3%;5 種重排的平均是 58.2% 與 42.9%,幾乎正好等於期望。也就是說,重排後兩邊和標記的對齊程度都只剩隨機水準。但隨機水準下,兩邊的學習方向不一樣,因為趨近型本來就比較多(56 比 41):懲罰仍有過半落在趨近型,輸了時好惡值仍略往負走,「輸了就少做」方向還對,只是弱很多;獎賞也有過半落在趨近型 MBON,意思是贏了之後,這個牌面配這個動作的好惡值反而往負走,模型從贏的手學到「下次別這樣打」。以下是推測,沒有拆開驗證,而且只和最差那一種重排(獎賞落在迴避型只剩 35.8%、成績 −65.0%)對得上,另外兩種反而比未訓練好。淨效果是:不管輸贏,做過的動作大多被壓低,比較常被做的動作被壓得最多;這為什麼會讓表往基本策略的反方向走,本課沒有拆開驗證,這只是方向上的推測。這和一致率全部掉到 37% 以下、最差一種成績到 −65% 相符,但不是證明;但它解釋不了全部:五種重排的獎賞都過半落在趨近型,照這個機制五種都該學反,實際上卻有兩種(−38.8%、−40.7%)成績比未訓練好,為什麼本課沒拆。五種重排裡獎賞對齊得最差的那一種(35.8%)正是成績最差的那一種(−65.0%);其餘四種的對齊程度和成績沒有一致的順序(對齊最好的 47.1% 那種成績 −40.7%,對齊 41.5% 的那種反而成績最好,−38.8%)。每種只有 3 個種子、種子之間差好幾個百分點,看不出比「最差的對最差的」更細的關係。
對齊比例由 scripts/x2_alignment.py 從作者的 data/mb_circuit.npz 算出,用與 bj_extra.py 相同的亂數重建 5 種重排,輸出在 out/blackjack/x2_alignment.json。
結論:在 21 點上,DAN→MBON 這層接線一換、標記留著,就學不會或只學到一點;KC 連到哪顆 MBON 不影響學完的水準(都停在永遠停牌附近)。作者推論的是「這層接線本身重要」,這次驗到的範圍比較窄:接線換掉、標記沒跟著換就壞,接線本身重不重要還沒和標記分開驗。接線換掉會壞,可能的原因是:作者的趨近/迴避標記本來就是從這層接線數出來的,兩者綁在一起才學得對;把接線換掉、標記留著,兩者就錯開,模型就學不會,最嚴重時學反。這也回答了 PART 1 第 4 節留下的問題「標記一半是資料、一半是人設」在實驗上意味著什麼。資料是「這顆 MBON 主要收懲罰群還是獎賞群的突觸」(從接線數出來),人設是「主要收懲罰群就標 +1」這條對應規則;兩者必須對齊,模型才能學,X4 會再從另一個角度看這件事。最直接的驗法是打亂之後把標記照新接線重新數一次、再打一次;本課沒做。若那樣又學會,就確定重要的是「接線與標記一致」,而不是這層接線本身。照本節的推理,預期會學會:X3 與本節前半顯示,在試過的兩種改法下(換一批 KC、打亂 KC→MBON),KC 這一層變了,學完都停在永遠停牌附近(多數是學上來的,少數起點就在那裡),只要削弱的方向對;重數標記正是把方向對回來。但這是預期,不是結果。兩種結果的意思不同:若重數後學會,表示在這種保留每顆 DAN 送出量的重排下,DAN→MBON 怎麼接都行,只要標記跟著它定,那麼「靠連結體學會」能說的就只剩「多巴胺分成獎賞、懲罰兩群,標記照它們的去向定」;若重數後仍學不會,才表示連結體量到的這層接線本身有作用。用 t 分布的係數 2.78,打亂 KC→MBON 的區間是 −18.9% 到 −12.2%,仍和完整模型重疊。
4X3 換一批 KC,結果會不會變
作者的選擇:蕈狀體路徑上(同時接到輸入神經元 PN、又連到輸出神經元 MBON)有 3,811 顆 KC,作者只取 1,200 顆:依每顆「從 PN 收到的突觸數加送到 MBON 的突觸數」(也就是它上下游連結的總量)排名、等距取:照排名每隔約 3 顆取 1 顆(3,811 顆取 1,200 顆),所以連結多的、中等的、少的 KC 都有(PART 3 第 3 節)。他說是為了省計算。懷疑:結果會不會是這 1,200 顆的特性?排名等距取到的是各種大小都有的 KC;換成隨機抽的 1,200 顆、或乾脆全部用上,21 點還學不學得會、學到一樣的水準嗎?檢法:用作者的切法程式重新切四個蕈狀體:全部 3,811 顆、以及三組隨機抽的 1,200 顆(三組用不同的亂數),每個蕈狀體打 3 個種子、各 30,000 手,和作者一樣用種子 0、1、2,所以可以直接和 PART 3 的 3 種子結果比。怎樣算過:作者選法的 3 種子平均 −14.8% 要落在每一種選法 3 個種子的 95% 信賴區間內。3 個種子的區間很寬,這條標準不嚴,所以結果表裡同時列出每個種子的值,讓你自己看散佈。
| KC 選法 | KC 數 | 3 個種子各自的成績 | 平均 | 95% 信賴區間 | 一致率(沒學過 → 學完) |
|---|---|---|---|---|---|
| 作者的選法(排名等距,PART 3) | 1,200 | −15.0%/−16.4%/−12.9% | −14.8% | −16.8% 到 −12.8% | 45.0% → 45.3% |
| 全部 | 3,811 | −16.1%/−9.2%/−12.6% | −12.6% | −16.5% 到 −8.7% | 45.4% → 42.3% |
| 隨機一 | 1,200 | −13.2%/−14.8%/−10.9% | −13.0% | −15.2% 到 −10.7% | 42.7% → 43.2% |
| 隨機二 | 1,200 | −15.0%/−12.1%/−9.8% | −12.3% | −15.2% 到 −9.3% | 40.8% → 40.1% |
| 隨機三 | 1,200 | −16.0%/−16.8%/−14.7% | −15.8% | −17.0% 到 −14.6% | 49.2% → 43.1% |
輸出在 out/blackjack/bj_extra.json 的 X3_kc_subsets(每種選法一個 variants 段落,n_kc 是顆數);作者選法那一列是 PART 3 第 4 節的重現結果(out/blackjack/bj2_blackjack_30000.json),它的信賴區間是 X1_seeds20 裡 first3 那一段。用全部 KC 切出來的連結數(22,581 條 PN→KC、57,823 條 KC→MBON)另存在 out/blackjack/bj1_edge_counts.json,和本節的判斷無關,PART 3 第 3 節拿它對 README。
結果:四種選法的平均都在 −15.8% 到 −12.3% 之間,作者的 −14.8% 落在每一種的區間內,四個蕈狀體都學到了「永遠停牌」上下的水準;一致率的欄要看「沒學過 → 學完」:每一種選法沒學過的一致率本來就不同(連結不同,沒學過時三個動作的好惡值就不同),學完有升有降,最多掉六個百分點(隨機三),和作者選法一樣沒有因為學習而明顯上升。全部 3,811 顆並沒有學得比較好(−12.6%,和 1,200 顆的幾組分不開),只是每 30,000 手從 13 秒變成 30 秒。每一種選法沒有共用 X1 的對照組:KC 不同,沒學過時的好惡值就不同,成績的起點也可能不同,所以本課另外補跑了每一種選法自己的未訓練(不學、不探索,種子 0、1、2 各 30,000 手):作者選法 −48.0%、全部 −55.3%、隨機一 −85.0%、隨機二 −22.8%、隨機三 −53.4%。起點差這麼多,是因為沒學過的表差很多:隨機一 260 格裡 250 格要牌、10 格加倍、沒有一格停牌,第一個決定從不停牌,幾乎每手都抽到爆,所以比亂選還差;隨機二 193 格停牌,接近永遠停牌,所以沒學就有 −22.8%。新切的四種(全部、隨機一到三)學完都比自己的未訓練好,但起點差很多:隨機二沒學就已經 −22.8%,學完只進步約 10 個百分點,其餘三種進步約 38 到 72 個百分點(作者選法是 33 個百分點)。用 t 分布的係數 4.30,四種選法的區間更寬(例如全部 3,811 顆是 −21.1% 到 −4.1%),作者的 −14.8% 仍落在每一種裡面。結論:學完的成績對 KC 怎麼挑不敏感,作者取 1,200 顆省計算,沒有改變結論;沒學過的成績則很敏感(−22.8% 到 −85.0%),所以每種選法要和自己的未訓練比,「學會了」才有意義。(沒學過的一致率、每種選法自己的未訓練成績、改用 t 分布的區間,以及 X2 那段的兩組範圍,都由 scripts/part4_extras.py 算出,在 out/blackjack/part4_extras.json 的 untrained_agreement、untrained_score_x3、t_intervals;沒學過時各動作的格數由 scripts/x3_untrained_tables.py 算出,在 out/blackjack/x3_untrained_tables.json。)
和 X2 的關係。這和 X2 是同一件事的兩面:在試過的兩種改法下(挑不同的 KC、打亂 KC 連到哪顆 MBON),KC 這一層變了,學完都停在永遠停牌附近(多數是從自己的起點學上來的,少數起點就在那裡)。不同的 KC 連法改變的是起點:沒學過時的好惡值、一致率與成績都跟著變(上一段的 −22.8% 到 −85.0%)。學習是從各自的起點去削弱 KC→MBON 的連結,削的方向由多巴胺送到哪些 MBON、那些 MBON 帶什麼標記決定;這說明了為什麼換了 KC 還學得會(方向沒變),但說明不了為什麼終點都在永遠停牌上下。為什麼正好停在那個水準、學不到基本策略的 −1.4%,本課沒有答案。能說的只有 X1 提過的那件事:很多張不同的 260 格表都打得出永遠停牌上下的成績,所以停在這裡的表不必長得一樣;至於模型為什麼學不上去,本課沒查(PART 1 第 5 節提到一個相容、但沒驗證的說法:「要牌常常輸」這種不分牌面的教訓可能蓋過了逐格的教訓)。決定學習方向對不對的,是 DAN→MBON 與標記有沒有對齊。
5X4 MBON 的趨近/迴避標記對得上文獻嗎
作者的做法:給每顆 MBON 標「趨近」或「迴避」的依據,是它主要接收哪一群多巴胺神經元:主要來自 PPL1(懲罰群)標趨近、主要來自 PAM(獎賞群)標迴避。為什麼被懲罰訊號管的反而叫趨近:多巴胺只會削弱,懲罰要讓好惡值下降,只能削弱 +1 型的輸入,所以被懲罰群管的 MBON 就被定義成 +1 趨近型(第 3 節走過的那條規則)。作者在 README(程式附的說明文件)明說沒有拿這些標記去對照文獻裡已鑑定的 MBON。懷疑:標記是從多巴胺輸入數出來的,沒有對過任何實驗證據。如果標記對不上真實果蠅,PART 3 的學習結果還成立嗎?標記能不能拿來談生物學?
檢法:用一條簡化的文獻規則做粗略對照。Aso 等人 2014 年在 eLife 用光遺傳學(把光敏蛋白放進特定神經元,用光就能讓它放電)逐類活化 MBON,看果蠅趨近還是迴避,發現釋放麩胺酸的 MBON 多半促成迴避,釋放乙醯膽鹼或 GABA 的多半促成趨近(doi:10.7554/eLife.04580)。傳導物質是神經元放電時釋放給下游的化學訊號,PART 1 第 3 節決定連結正負號的也是它。這條規則有已知的例外,這裡只當粗略對照。MBON 的傳導物質用 MaleCNS(作者用的那份雄果蠅腦連結體資料)附的預測值:它是從電子顯微鏡影像用機器學習猜出來的,可能猜錯,猜錯的那顆就會被算到錯的一列,所以這張表也只能當粗略對照。怎樣算過:這一項沒有「過/不過」的門檻,要回答的是「一致的比例有多高」,以及不一致對 21 點的結果有沒有影響。與作者的標記列成交叉表:
| 預測的傳導物質 | 作者標趨近 | 作者標迴避 | 文獻規則預期 |
|---|---|---|---|
| 乙醯膽鹼 | 38 | 12 | 趨近 |
| GABA | 8 | 13 | 趨近 |
| 麩胺酸 | 10 | 16 | 迴避 |
粗體是與規則一致的三格:乙醯膽鹼標趨近 38 顆、GABA 標趨近 8 顆、麩胺酸標迴避 16 顆。輸出在 out/blackjack/bj_extra.json 的 X4_mbon_valence,含逐顆的對照表。
結果:一致的是 38 + 8 + 16 = 62 顆,占 97 顆的 64%;GABA 那一群多數相反。64% 算高還是低:若標記和傳導物質無關、只保留 56 顆趨近與 41 顆迴避的比例,照交叉表的行列總數算,碰巧一致的期望是 52 顆(53.6%);62 顆比它多了十顆,有對上的跡象但不強:把作者的 56/41 標記隨機重新分給 97 顆、重排 100,000 次,一致數達到 62 顆以上的只有約 1.9%,所以不太像純粹碰巧,但仍有 35 顆不一致(期望值由 scripts/part4_extras.py 算出,在 out/blackjack/part4_extras.json;重排檢定由 scripts/x4_permutation.py 算出,在 out/blackjack/x4_permutation.json)。結論:標記只部分對得上文獻(64%,高於碰巧,但約三分之一相反),這分成兩件事。第一,現有標記下的 21 點結果不受「標記和生物學對不上」影響(推論,沒有實測),原因就是 X2 量到的那件事:標記本來就是從 DAN→MBON 的接線數出來的,主要被懲罰多巴胺管的 MBON 一定被標成趨近型,所以「輸了就削弱趨近型的輸入」在模型裡依定義成立,不需要標記對得上真實果蠅;X2 把接線換掉、標記留著,學習才壞掉。第二,若把標記改成照文獻規則,那就是另一個模型(推論,沒有實測):三分之一的 MBON 會翻號、和 DAN→MBON 接線錯開,照 X2 的結果模型可能反而學得更差:在這個模型裡,要學得會,標記得跟著接線走,不一定跟著生物學走。但它也表示:「哪些 MBON 驅動趨近」不能從這個模型讀出生物學結論,有三分之一的標記和文獻規則相反。要逐顆確認,得把 MaleCNS 的 MBON 編號對到文獻裡已鑑定的 MBON,本課沒有做。